この記事で分かること
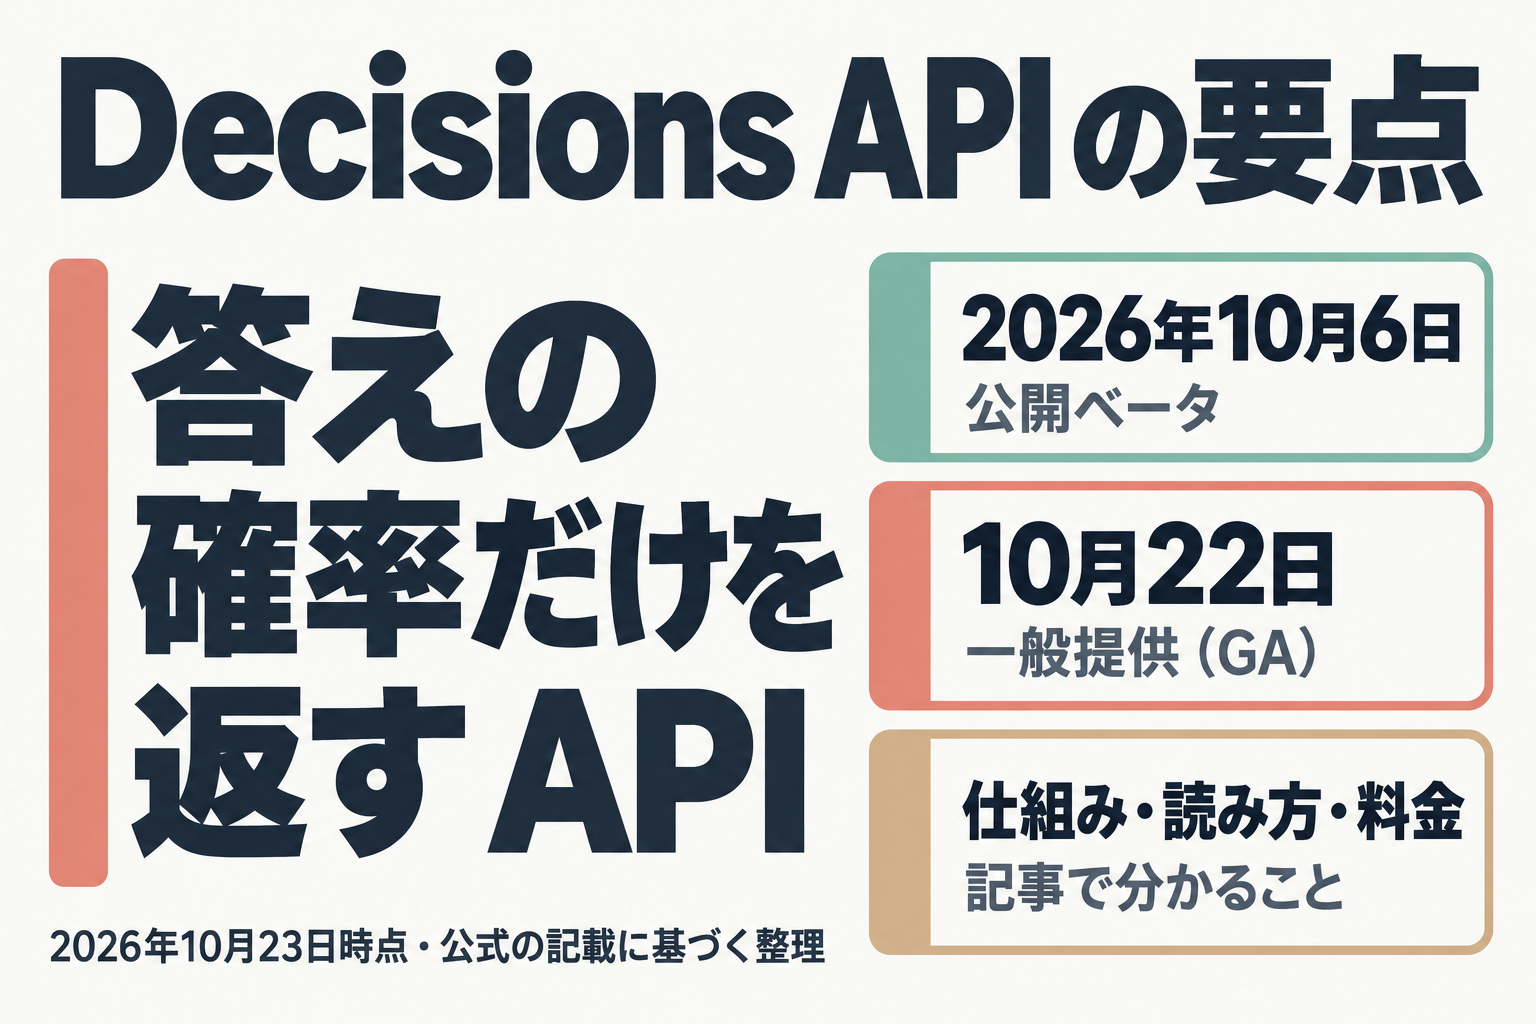
Decisions API は、AI に文章を書かせず「答えの確率だけ」を返させる API です。 問い合わせを担当部署に振る、不具合の深刻度を点数にする、といった判断の部分だけを切り出せます。OpenAI は 2026年10月6日に公開ベータとして出し、10月22日に一般提供(GA)になりました(変更履歴の記載。2026年10月23日時点)。
この記事を読むと、次の3つを自分の言葉で説明できます。
- 何を返す API で、従来の呼び出しと何が違うか
- リクエストをどう組み立て、返ってきた値をどう読むか
- 料金がいくらで、今日試すか見送るか
本記事は公式ガイド・変更履歴・料金ページ・モデルページの記載に基づく整理です。API を実際に呼び出しての計測は行っていません。速度の数値も公式の説明をそのまま引用します。ベータ公開時点の解説はこちらの記事にありますが、GA で変わった点があるため、本記事は現在の公式の記載にそろえています。
迷ったらこれ:振り分け・分類を大量にさばくなら、今日試す
問い合わせの振り分け、優先度付け、画像の合否判定のように「選ぶだけ」の処理が多いアプリを作っている人は、Decisions API を試してください。 理由は3つです。
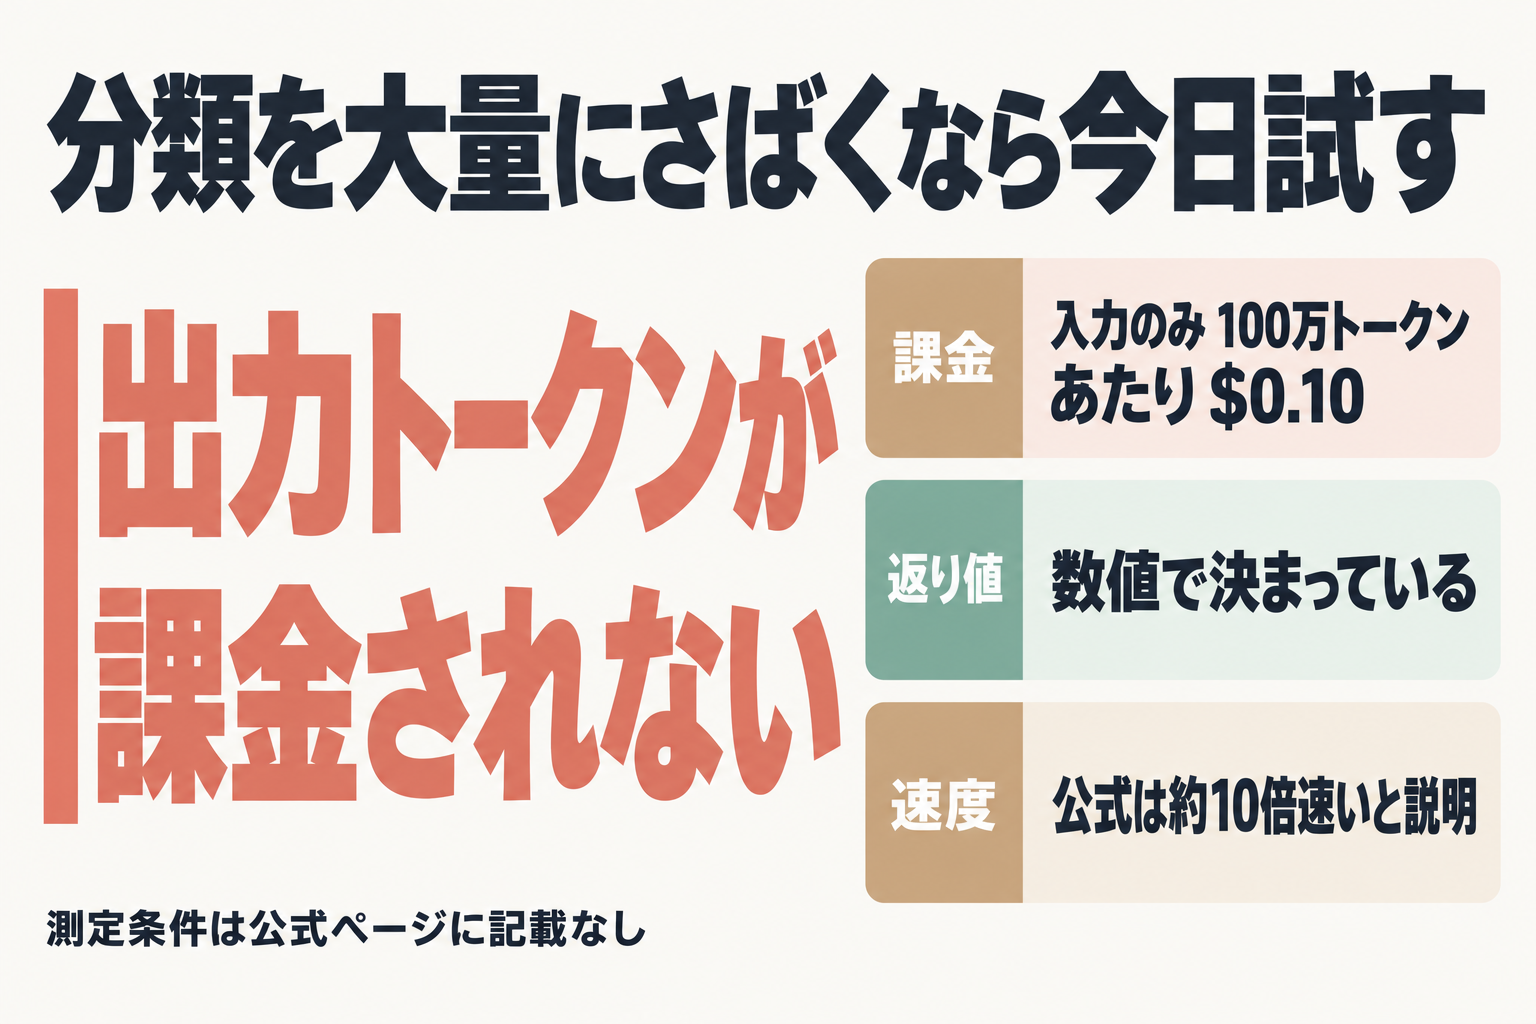
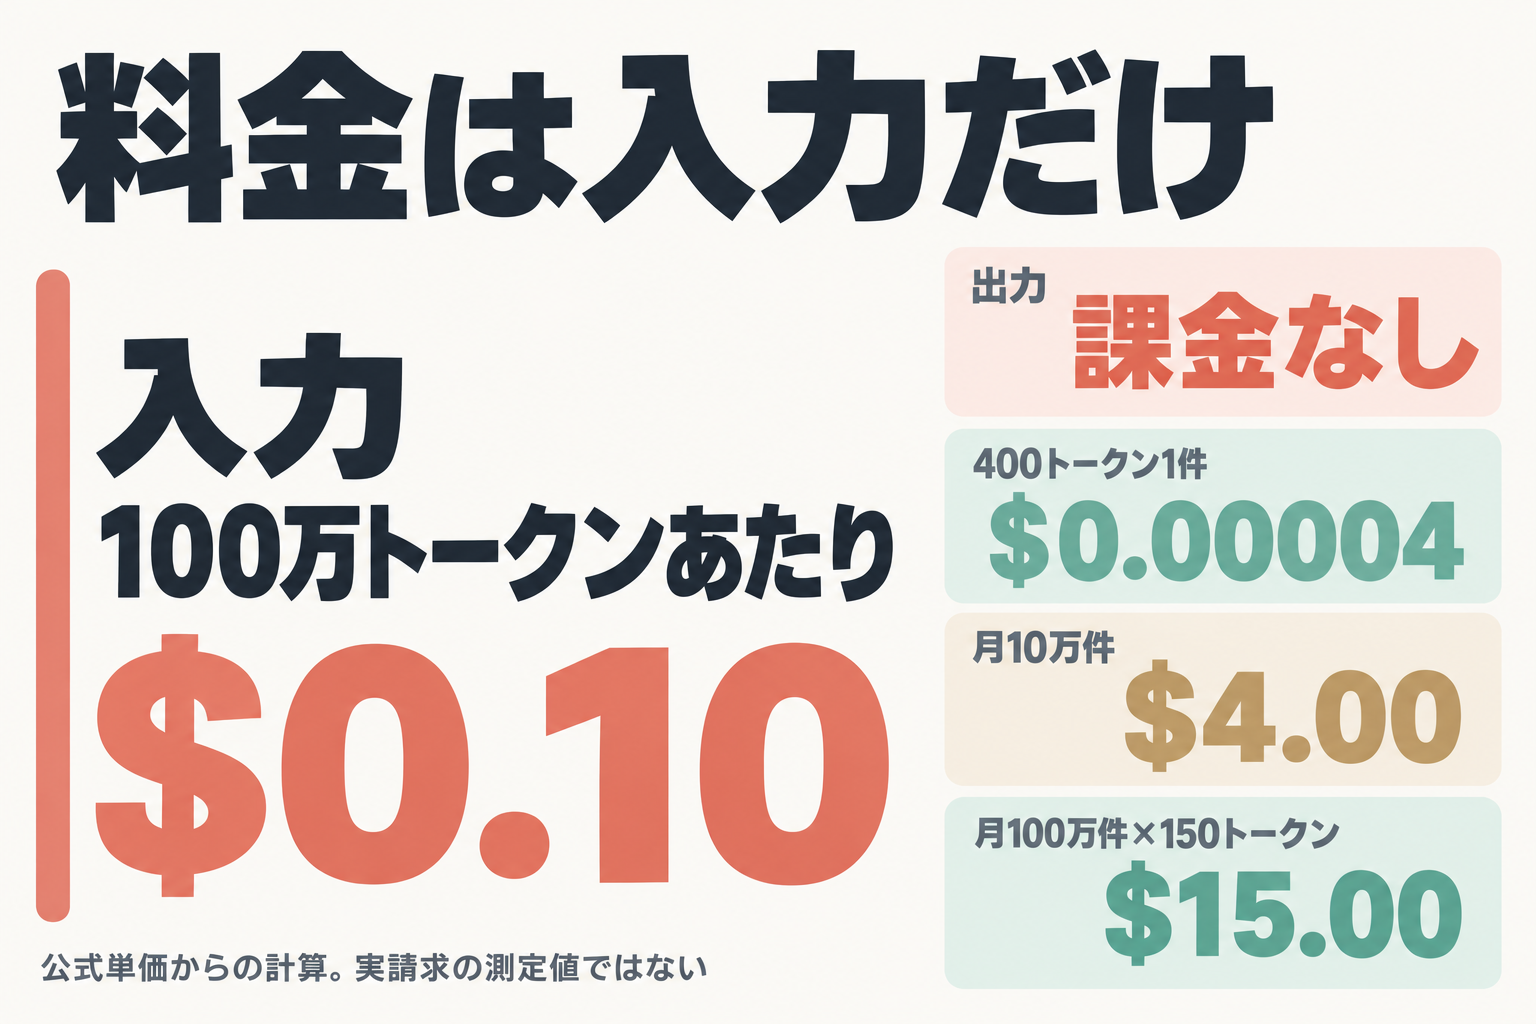
- 出力トークンが課金されない。 課金されるのは入力だけで、100万トークンあたり $0.10 です。1リクエストが400トークンなら $0.00004(計算式は後述)。
- 返り値が数値で決まっている。 文章をあとから解析する必要がなく、「確率 0.9 以上なら自動処理、未満なら人の確認」と閾値で分けられます。
- 公式が「Responses API より約10倍速い」と説明している。 ただし測定条件は公式ページに書かれていないので、自分の環境での確認は必要です。
向かない人:要約・文章作成・チャット返答のように「文章そのもの」が欲しい人。日本語での利用を前提にした記載は公式ガイドの本文に見当たらず、サンプルはすべて英語です。日本語の精度は自分のデータで確かめる前提になります。
最初の5分でやること: 自分の仕事で「振り分けたい文面」を1件選び、どんな選択肢に分けたいかを3〜4個書き出します。そのまま、後の「呼び出し方」のリクエスト例の input と選択肢になります。公式ガイドには Playground の案内もあります。
Decisions API とは:「判断」だけを返す API
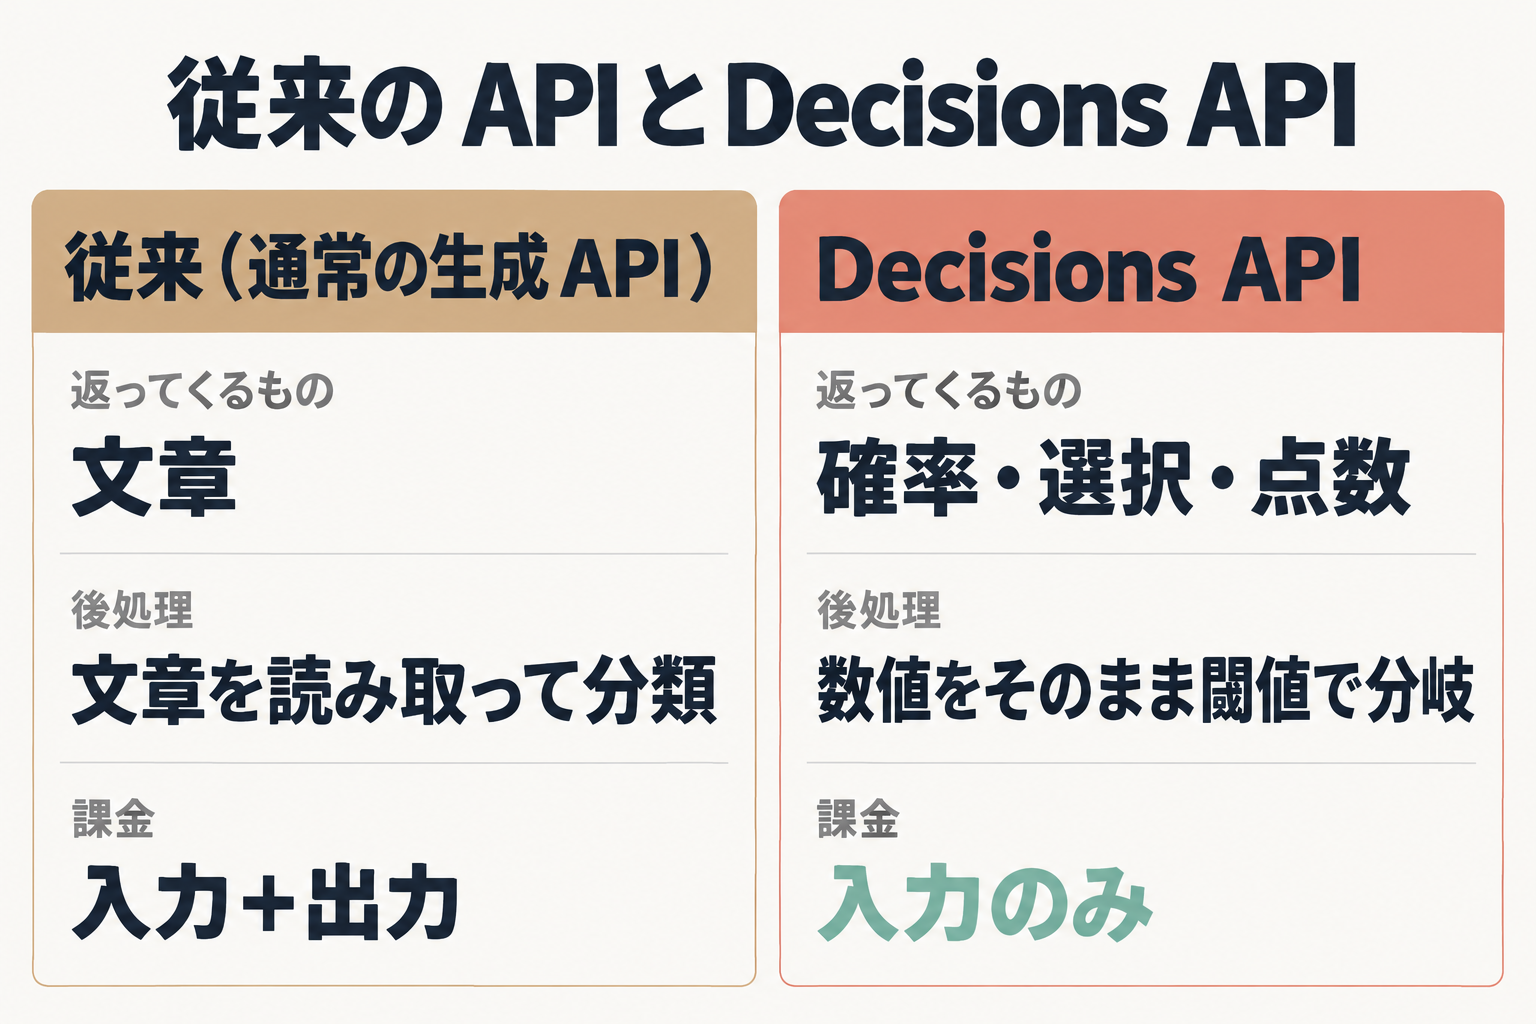
従来の生成 AI の API は、質問すると文章で返事が返ってきます。Decisions API は違います。テキスト・画像・JSON を読んで、あらかじめ決めた「質問」に型付きの答えだけを返します。 公式が挙げる用途は、分類、リクエストの振り分け、作業の優先順位付けです。
- エンドポイントは
POST /v1/decisions - 対応モデルは
gpt-6-lunaの1種類のみ(公式が「現時点で唯一」と明記) - リクエストは3つの要素:
model、input(判断の材料。文字列、またはメッセージ・ツール呼び出し・ツール出力の配列)、questions(質問の一覧) - 各質問に名前(
name)を付けると、回答にもその名前が付いて返る
Before → After で言い換えると:
| 従来(通常の生成 API) | Decisions API | |
|---|---|---|
| 返ってくるもの | 文章(「これは請求の件だと思います」など) | 確率・選択・点数 |
| 後処理 | 文章を読み取って分類する処理が必要 | 数値をそのまま閾値で分岐 |
| 課金 | 入力+出力 | 入力のみ |
3つの型:predicate・choice・score
質問の型は3つです。ここが一番大事なので、公式の例といっしょに見てください。
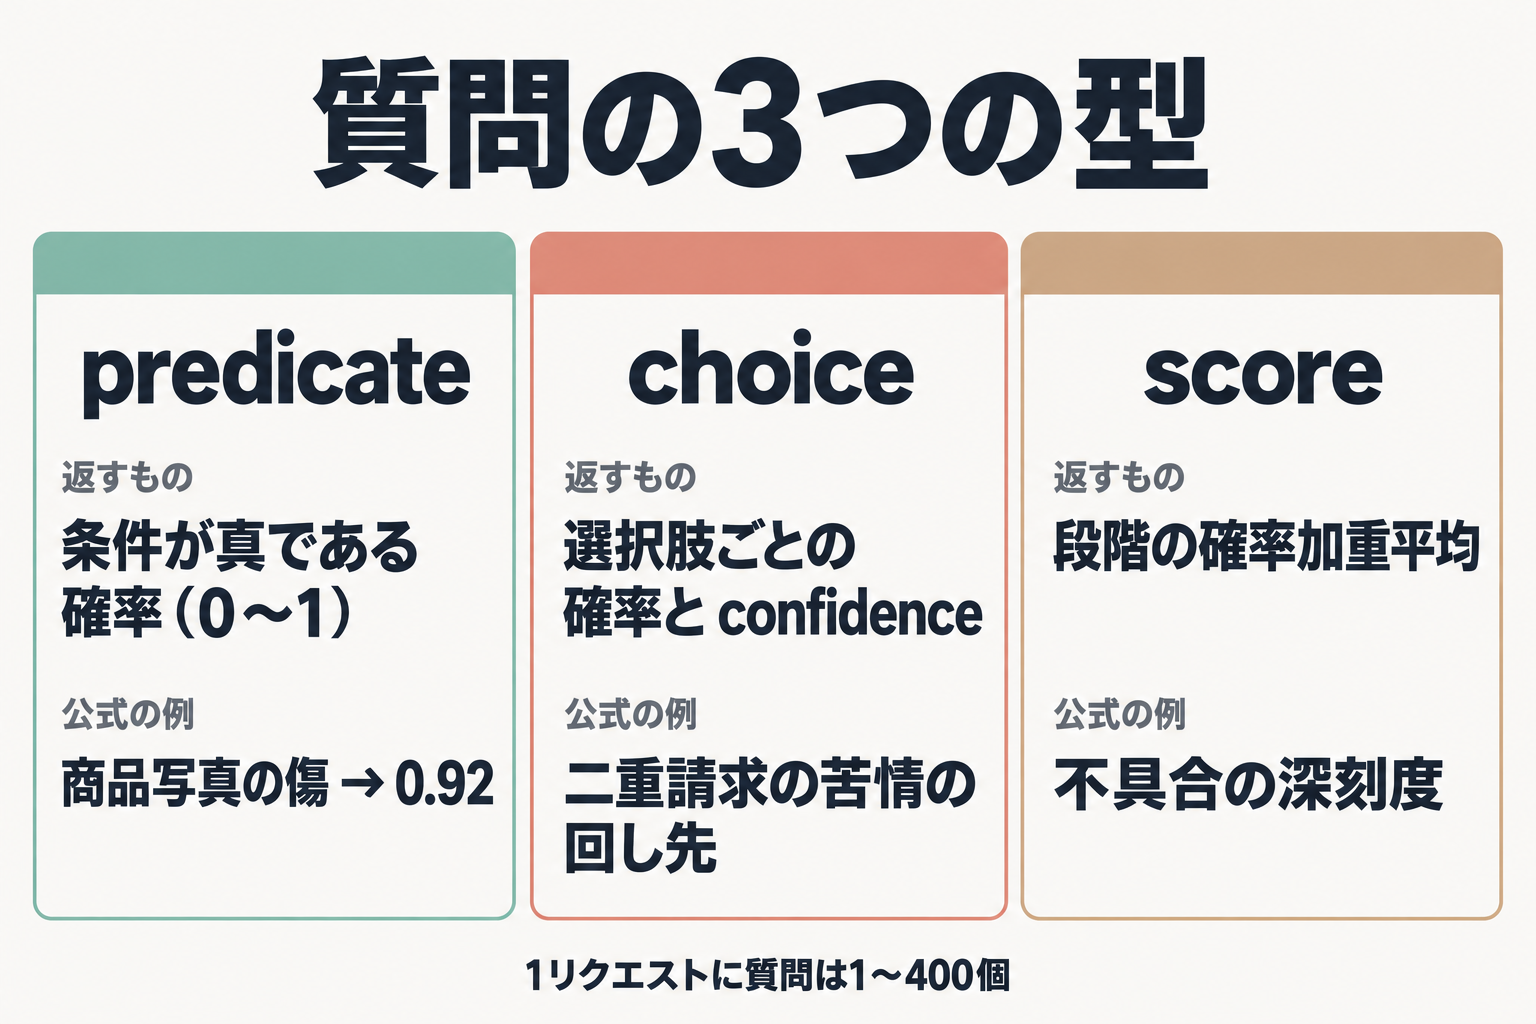
| 型 | 返すもの | 公式の例 |
|---|---|---|
| predicate | 条件が真である確率(0〜1) | 商品写真に目に見える傷があるか → 0.92 |
| choice | 用意した選択肢から1つを選び、各選択肢の確率と confidence を返す | 二重請求の苦情をどの部署に回すか |
| score | 順序のある段階(2〜10段階)の確率加重平均 | 不具合の深刻度 |
predicate:はい/いいえの確率
公式の例は商品写真の傷の検出で、visible_damage の確率が 0.92。指示文は「影と外箱の傷は無視する」です。何を数えないかまで書くのが公式の作法です。
choice:1つに決める
選択肢は billing / technical / shipping / other の4つ。結果は billing 0.95、technical 0.02、shipping 0.01、other 0.02、confidence 0.93。「どれにも当てはまらない」場合に備え、other のような予備を置くよう公式は勧めています。
score:点数で受け取る
3段階(0=見た目だけ、1=回避策あり、2=完全に使えない)で、確率が 0.1/0.7/0.2 なら、score は 0×0.1+1×0.7+2×0.2=1.1、confidence は 0.55 です。段階の間の値になるのが特徴です。1つの分類に決めて処理を分けたいなら、公式は choice を使うよう書いています。
質問の書き方(公式の要点)
- 目に見える・読み取れる基準で書く
- 別の関心事は別の質問に分ける
- 選択肢の意味が重ならないようにする
- score は隣り合う段階で基準を変える
- 前の答えに依存する判断(先に傷を調べ、その結果で修理カテゴリを聞く)は別リクエストにする
1リクエストに入れられる質問は1〜400個で、質問ごとに型を変えられます。
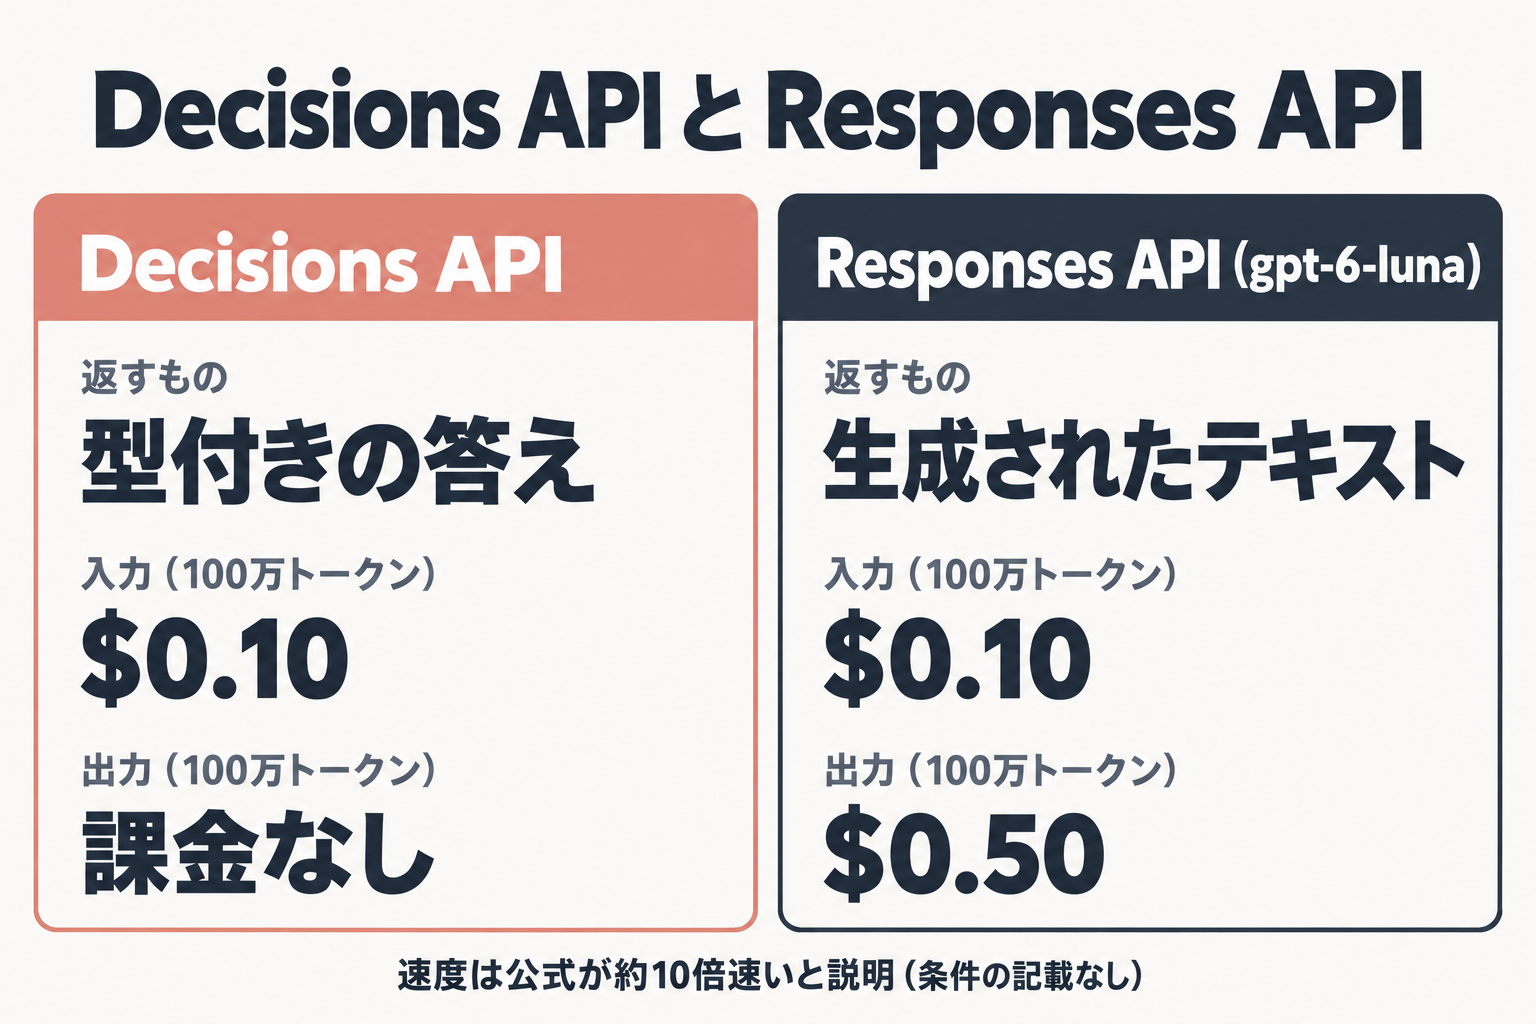
Responses API との違い:出力の形・速度・料金
| 項目 | Decisions API | Responses API(gpt-6-luna) |
|---|---|---|
| 返すもの | 型付きの答え | 生成されたテキスト/指定した JSON |
| 入力単価(100万トークン) | $0.10 | $0.10 |
| 出力単価(100万トークン) | 課金なし | $0.50 |
| 速度 | 公式は「約10倍速い」と説明(条件の記載なし) | — |
入力単価は同じで、差は出力です。出力が長くなる用途ほど、Decisions API の「出力は課金なし」が効きます。 差額は用途ごとの出力量で変わるため、ここでは金額を断定しません。
OpenAI の速度重視の API としては、GPT-6.1 Sol Ultrafast の解説も参考になります。
呼び出し方:choice 質問1件のリクエスト例
公式の SDK 例は JavaScript、Python、Go、Java、Ruby、curl に載っています。Python では client.decisions.create(...) に、model、input、questions の3つを渡します。
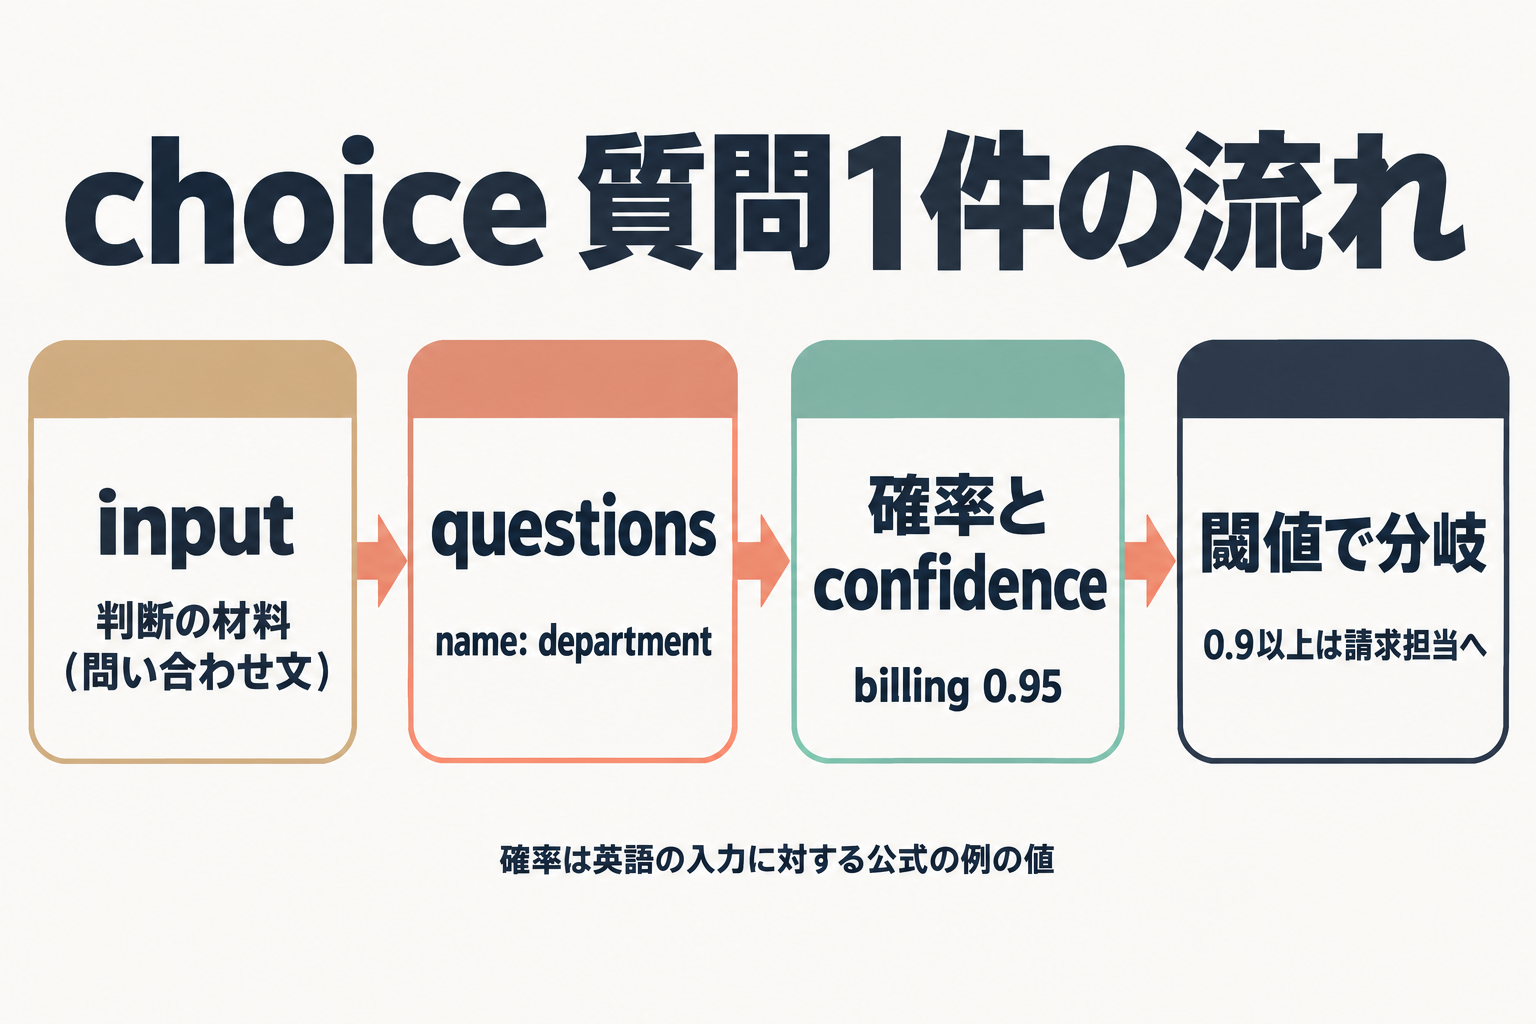
実際のフィールド名は公式ドキュメントで確認してください。下は、公式の「二重請求の苦情を回す」例を日本語の入力にして、choice 質問を1件だけ入れた最小のリクエストです。API キーを設定した環境で動かします。
from openai import OpenAI

client = OpenAI()

result = client.decisions.create(
    model="gpt-6-luna",
    input="先月分と今月分の両方が引き落とされています。二重に請求されているので、すぐ確認してください。",
    questions=[
        {
            "name": "department",  # 質問ごとに一意の名前。回答にもこの名前が付いて返る
            "instructions": "この問い合わせを、どの担当部署に回すべきか選ぶ。",
            # ここに「型は choice」と、選択肢 billing / technical / shipping / other を書く
            # (書き方は公式ガイドの Python の例を写す)
        },
    ],
)
コメントの部分(型の指定と選択肢)は、公式ガイドの Python の例の書き方をそのまま写してください。この記事では、公式で確認できた中身を表にしました。
| 項目 | 中身 |
|---|---|
| 質問の名前 | department(自分で付ける。回答にも同じ名前が付く) |
| 型 | choice |
| 選択肢 | billing / technical / shipping / other(公式の例と同じ4つ。迷うものを受ける other を必ず入れる) |
この1件なら入力は400トークン想定で、公式単価では $0.00004 です。
返ってくる値の例
公式の choice の例(二重請求の苦情)で返る値は次のとおりです。英語の入力に対する公式の値で、上の日本語の入力を実際に送った結果ではありません。
| 項目 | 意味 | 公式の例の値 |
|---|---|---|
| billing | 請求担当である確率 | 0.95 |
| technical | 技術担当である確率 | 0.02 |
| shipping | 配送担当である確率 | 0.01 |
| other | どれにも当てはまらない確率 | 0.02 |
confidence | 答え全体の確からしさ(確率とは別の項目) | 0.93 |
この例なら「billing が 0.9 以上なら請求担当へ自動で回し、未満なら人が確認する」と閾値で分けられます。
答えの読み方
返ってくるのは、質問に付けた name ごとの答えです。
- 型ごとに見るものが違う。 choice は選択肢ごとの確率、score は段階ごとの確率とその加重平均、predicate は「真である確率」ひとつです。公式の例では、choice の二重請求の苦情は billing が0.95、
confidenceが0.93、score は確率が0.1/0.7/0.2で1.1、confidenceが0.55、predicate の傷の検出は0.92でした - 確率と
confidenceは別物。 choice と score は確率の分布を返し、confidenceは別の項目です。公式の score の例のように、値が1.1でもconfidenceは0.55と低いことがあります - 閾値は自分のデータで決める。 公式は「自分のアプリのラベル付き例で、ルーティング・絞り込み・人の確認の閾値を決め、偽陽性と偽陰性のコストで決める」と書いています
- 拒否への備え。 質問が拒否されると、その回答の
typeは"refusal"になります。公式サンプルもrefusalを分岐で処理しています。nameで、どの質問が拒否されたかを見分けます - 使用量の確認。 キャッシュを使ったときは、
cached_tokensとcache_write_tokensで利用分を確認できます
公式の英語サンプルでは billing が0.95、confidence が0.93でした。日本語で同じ精度になるかは、公式の記載がありません。
入力に渡せるもの
- 会話履歴(user / developer / system / assistant のメッセージ、関数呼び出しとその出力)
- ユーザーメッセージ内の JSON(
input_json) - 画像:base64 のデータ URL か、公開されている HTTP/HTTPS の URL。ベータ期間は base64 のみでしたが、GA で URL 渡しが加わりました。 各質問の指示文にも画像を入れられ、その画像は
inputの画像と同じ上限を共有します file_id、ファイル、音声は非対応です
プロンプトキャッシュにも対応しています。共有 input の先頭部分を再利用でき、再利用できる接頭辞は 1,024 トークン以上が必要です。
料金:入力だけにかかる
公式の料金(2026年10月23日時点):
| 項目 | 内容 |
|---|---|
| 入力(キャッシュなし) | 100万トークンあたり $0.10 |
| 出力 | 課金なし |
| キャッシュ読み取り・書き込み | gpt-6-luna の標準のキャッシュ料金と同じ |
| 地域処理 | 割増が適用(gpt-6-luna では10%) |
| 長い入力 | 倍率が適用(272K入力トークン超は入力が2倍) |
月額の換算例(公式単価からの計算。実請求の測定値ではありません)
- 1リクエスト 400トークン:400 × $0.10 ÷ 1,000,000 = $0.00004
- 月10万リクエスト × 400トークン=4,000万トークン → 40 × $0.10 = $4.00
- 月100万リクエスト × 150トークン=1.5億トークン → 150 × $0.10 = $15.00
為替は各自で換算してください。キャッシュや地域処理を使う場合は、上の表の条件を足して計算します。
利用上限と確認方法
gpt-6-luna 全体のレート制限は、Build が 5,000 RPM / 2,000,000 TPM、Launch が 10,000 RPM / 10,000,000 TPM、Grow が 30,000 RPM / 180,000,000 TPM です(ティアの条件は累計購入額 $5 / $100 / $500 以上)。ただし、この表が Decisions 専用なのか Responses と共有なのかは公式に書かれていません。使用量は GET /v1/organization/usage/decisions で確認でき、管理者 API キーと api.usage.read 権限が必要です。複数の質問を1回で送ってもリクエスト数は1回と数えられます。
Jev・Clef との違い
「質問に型付きで答える」タイプのモデルは OpenAI だけではありません。
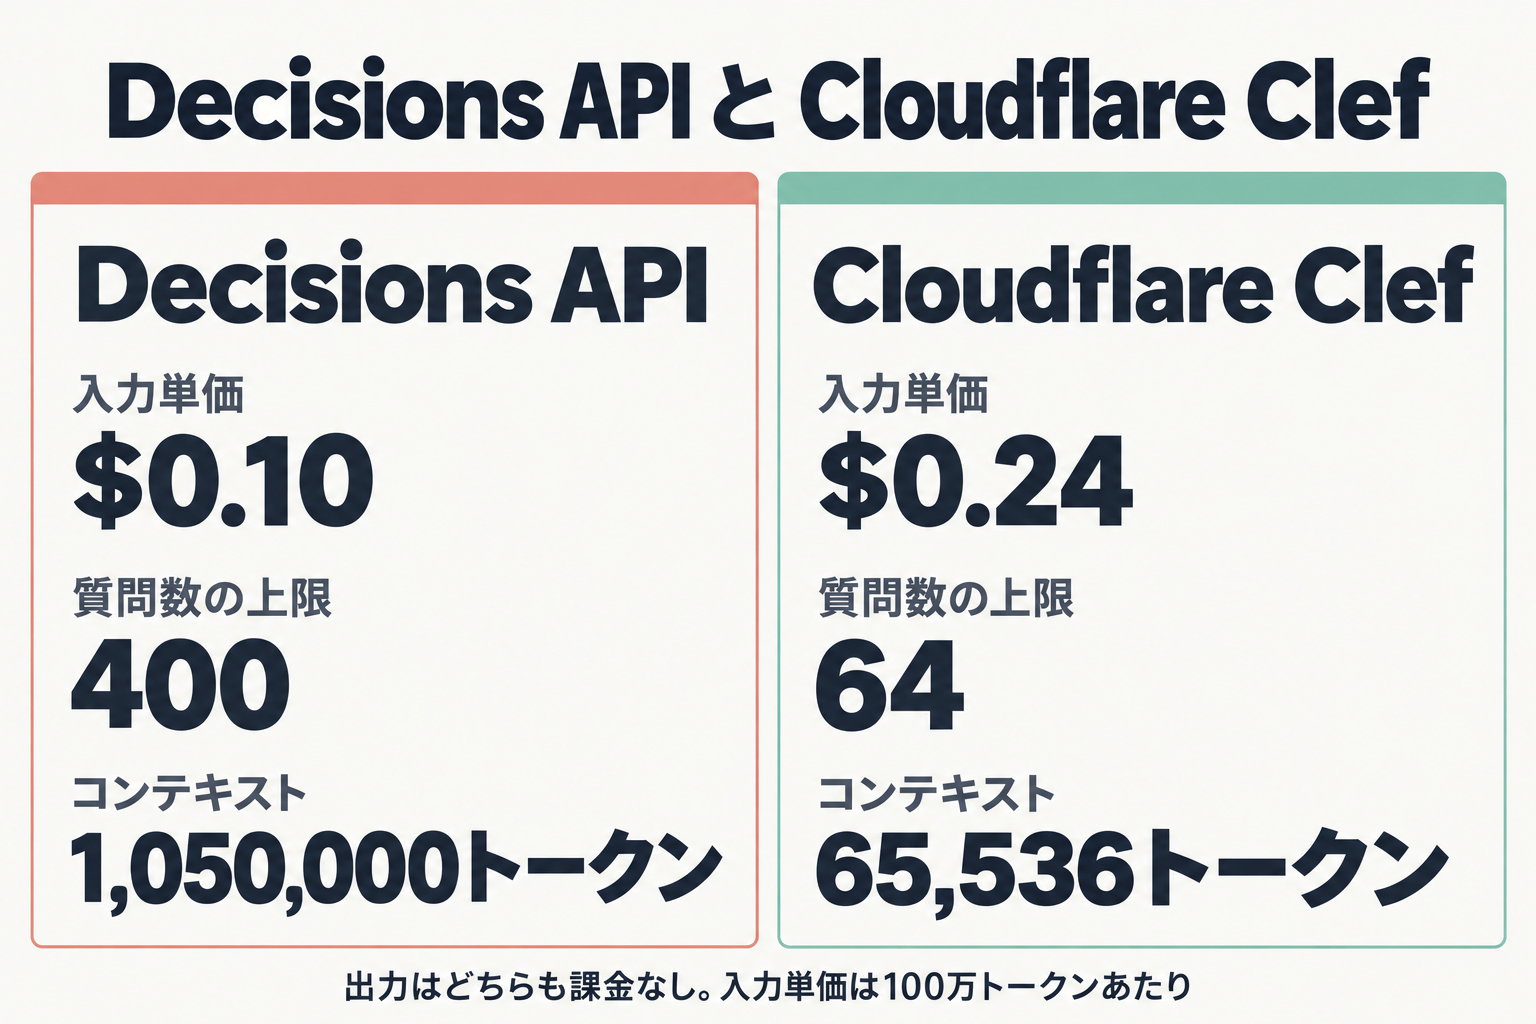
| 項目 | Decisions API | Cloudflare Clef |
|---|---|---|
| 入力単価(100万トークン) | $0.10 | $0.24 |
| 出力 | 課金なし | 課金なし |
| 質問数の上限 | 400 | 64 |
| コンテキスト | 1,050,000トークン(gpt-6-luna) | 65,536トークン |
| 型の呼び名 | predicate / choice / score | noul / choice / score |
Clef は27Bのマルチモーダル判断モデルで、画像は32×32の区画を1トークンとして数え、1枚あたり最大1,024トークンです。Jev は TypeSafe が「System One model」(テキストを生成せず型付きの答えを返すモデル)の第1号として公開していて、型は Choice と Score(目次には Noul もあります)。Jev は公式ドキュメントに単価の記載がないため、ここには載せません。
すでに Cloudflare や TypeSafe を使っているなら、そのまま使い続ける理由は残ります。 OpenAI の他の API と同じアカウント・請求でまとめたい人は Decisions API が自然です。
どんな場面で使えるか
公式が挙げる用途と、仕事への置き換えです。
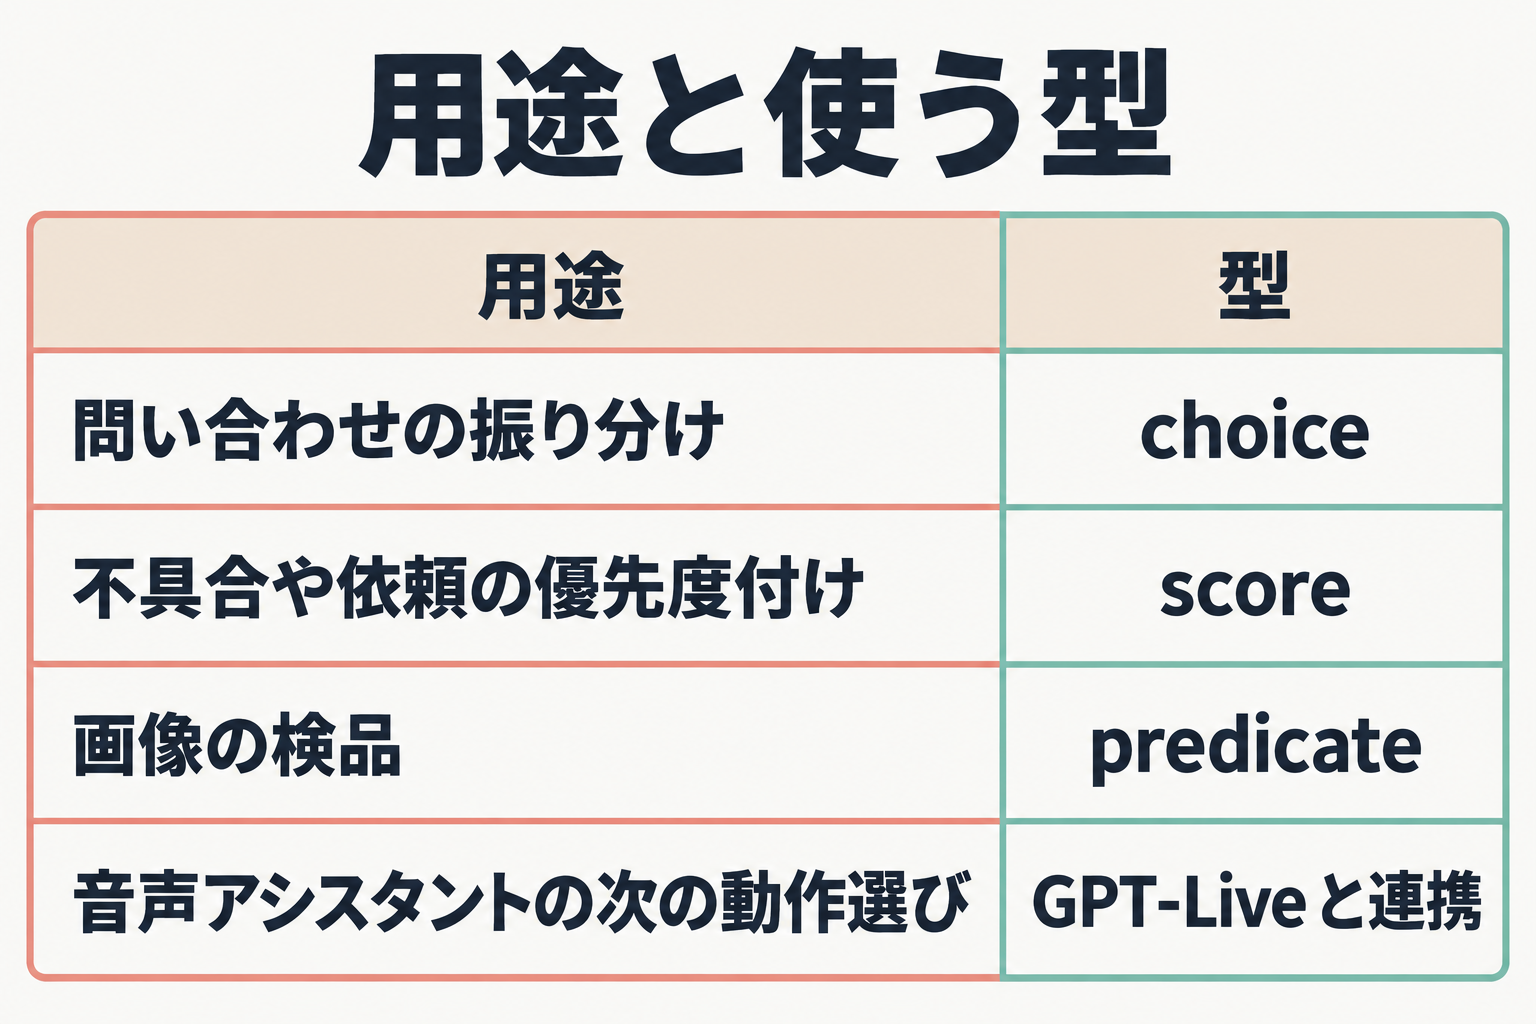
- 問い合わせの振り分け(choice):二重請求の苦情を請求担当へ。
otherを置いて、迷うものは人の確認へ。AIエージェント導入の実例も参考に。 - 不具合や依頼の優先度付け(score):深刻度を点数にして、並べ替える
- 画像の検品(predicate):商品写真に傷があるか。影や外箱は無視と指示で除外する
- 音声アシスタントの次の動作選び:2026年10月15日に GPT-Live との連携が加わりました。公式の例は車載アシスタントで、「少し寒い」なら温度を上げる、「曇りを取って、サンフランシスコへ案内して、レストランを探して」なら曇り取りをオンにして Responses を呼ぶ、という振り分けです
開発者にとっては、判断を軽くして応答を速くできる道具です(速さは公式の説明による)。非エンジニアの担当者にとっては、「AI が出した確率で、自動処理と人の確認の境目を数字で決められる」ようになる、という意味があります。
向いている人・向かない人/結局どうするか
判断軸は3つです。
- 欲しいのは文章か、判断か。 判断(分類・選択・点数)なら Decisions API。文章なら従来の API
- 件数が多いか。 大量にさばくほど、出力課金なしと速さが効く
- 日本語の精度を自分で確かめられるか。 公式の記載は英語のサンプルのみ。閾値の調整用に、自分のラベル付き例を用意できる人向き
結論: 分類・振り分けの処理があり、件数が多いなら今日試す。文章生成が主目的、または日本語精度を確認する手間をかけられないなら見送り。GA になったので、ベータ期間の情報(画像は base64 のみ、質問は200個までなど)とは公式の記載が変わっている点に注意してください。
今日の行動は1つだけです。自分の仕事で実際に振り分けている文面を1件選び、上の「呼び出し方」のリクエスト例のように other つきの choice 質問にして、返ってくる確率を見る。 確率が納得できる並びなら、同じリクエストの questions に score や predicate の質問を足していきます。
出力は課金されず、入力 400 トークンの1件なら公式単価で $0.00004 です。1件試す費用は気にならない水準なので、まず手元の1件から始められます。
入力は100万トークン$0.10で出力は課金なし。
OpenAI Decisions API の料金プランを確認する(公式)