OpenAIが、入力を評価して「どれに当てはまるか」だけを返す Decisions API を、全開発者向けの公開ベータとして出しました(公式コミュニティの告知は2026-10-06)。文章は作りません。返すのは、条件を満たす確率、選んだ選択肢、段階評価の数値です。公式は、GPT-6 Luna を Responses API 経由で使うより最大10倍速いと説明しています。
本記事は公式ガイド、モデルページ、料金ページ、公式コミュニティの告知の整理です。Decisions API を実際に呼んだ結果ではありません。速度の数字も公式の説明であり、自分では計っていません。
つまり何が起きたのか:「文章を作らない」API が加わった
アプリの中には、文章を作る前に決めることがよくあります。この問い合わせはどの部署か、この画像に傷はあるか、この不具合はどれくらい深刻か、といった判断です。これまでは自前のルールで書くか、大きなモデルに文章で答えさせて結果を読み取っていました。
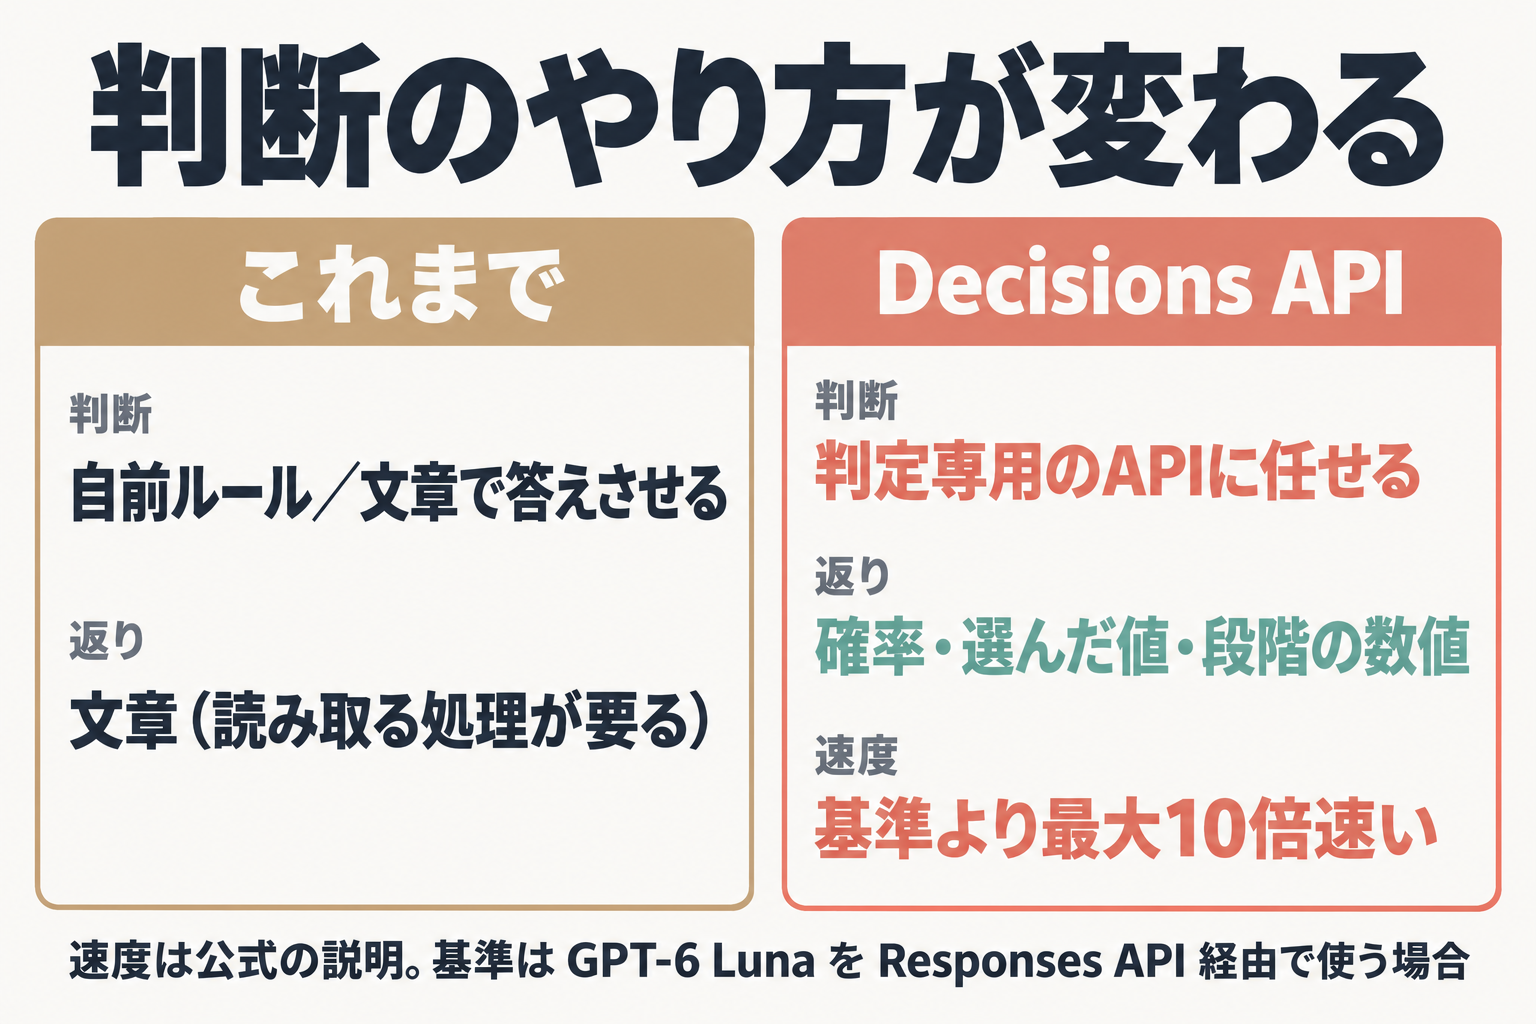
Decisions API は、この判断だけを専用のエンドポイント(POST /v1/decisions)に任せるためのものです。公式の説明では、テキスト、画像、またはその両方を評価し、型の決まった答えを返します。用途は分類、ルーティング(振り分け)、優先度付けです。
| これまで | Decisions API | |
|---|---|---|
| 判断のやり方 | 自前のルール、または大きなモデルに文章で答えさせる | 判定専用のAPIに任せる |
| 返ってくるもの | 文章(読み取って整える処理が要る) | 確率・選んだ値・段階の数値 |
| 速度(公式の説明) | 基準:GPT-6 Luna を Responses API 経由で使う場合 | その基準より最大10倍速い |
迷ったらこれ
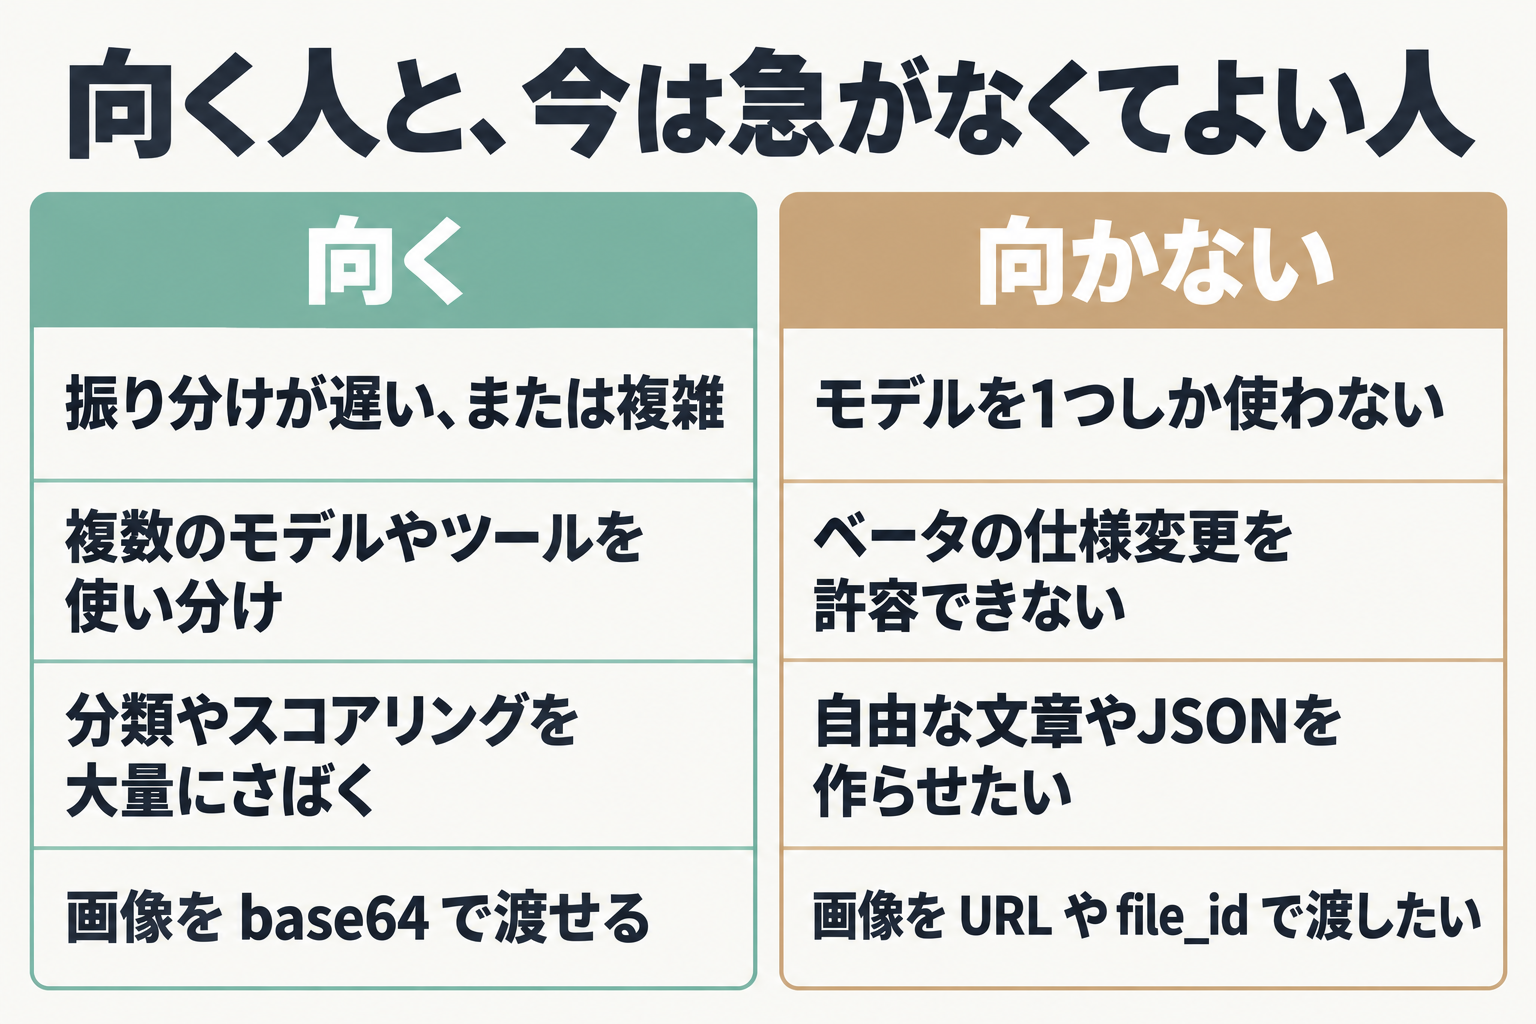
- 複数の振り分けを持つアプリを作っている人は、判断が1か所だけの小さな処理から Decisions API に置き換えてみてください。
- 根拠は、公式が速度を最大10倍としていること、そして料金が入力 $0.10/100万トークンで、出力トークンは課金なしと案内されていることです(出典は公式ガイドとコミュニティ告知)。500トークンの入力なら、単価からの換算で1万回の判定が約 $0.50 です(実際の請求額ではありません)。
- 最初の5分は、公式ガイドで
gpt-6-lunaと3種類の判定の定義を読むことです。次に、自分のアプリで「選択肢から1つ選ぶ処理」を1つ決めます。 - モデルを1つしか使わないアプリや、ベータの仕様変更を許容できない本番用途の人は、今は急がなくて構いません。
何ができるのか:3種類の判定
判定は3種類です。使い分けは「条件か、分類か、レベルか」で決まります。
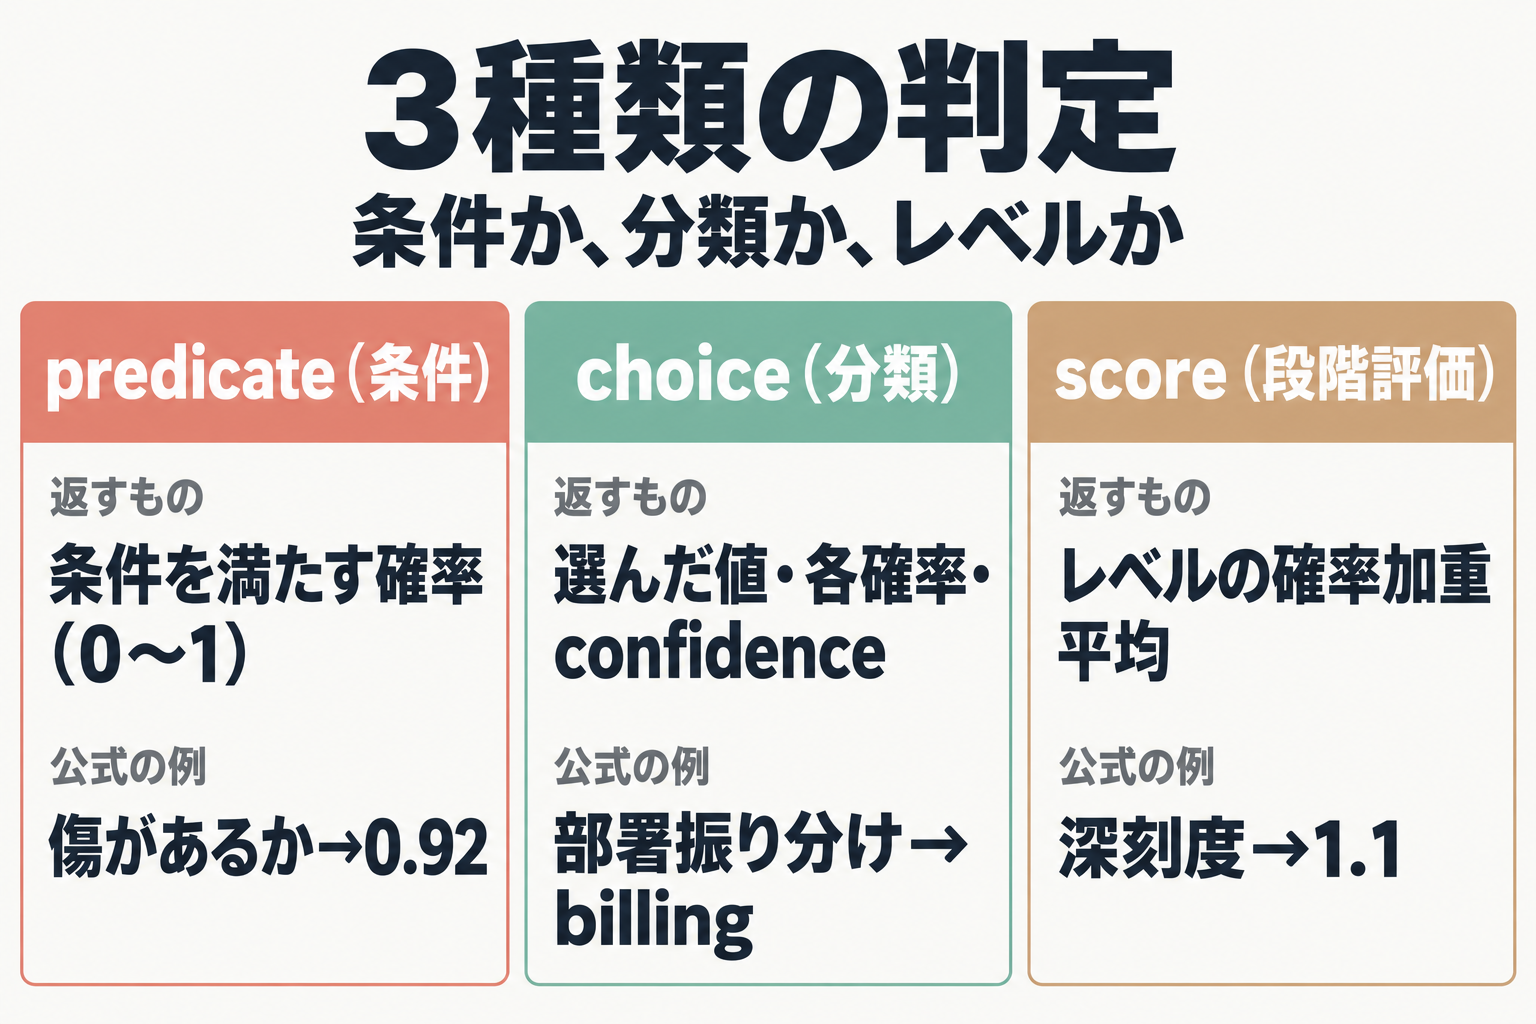
| 種類 | 何を返すか | 公式の例 | 向く場面 |
|---|---|---|---|
| predicate(条件) | 条件を満たす確率(0〜1) | 「傷があるか」→ probability 0.92 | はい/いいえで決める処理 |
| choice(分類) | 選んだ値、各選択肢の確率、confidence(信頼度) | 苦情の部署振り分け → billing、confidence 0.93 | 順序のない選択肢から1つ選ぶ処理 |
| score(段階評価) | レベル番号の確率加重平均、各レベルの確率、confidence | 深刻度(0=見た目のみ/1=回避策あり/2=作業不能)→ 1.1 | 順序のあるレベルで測る処理 |
score の 1.1 は、各レベルの確率で重みづけした平均値です。0に近いほど軽く、2に近いほど重い、という目盛りで、この例は「1(回避策あり)あたり」と読めます。処理を分けるなら、数値の範囲ごとに対応を決めます。
リクエストと返り方:3つの要素だけ
リクエストの要素は model、input、questions の3つです。使えるモデルは公開ベータの時点で gpt-6-luna のみです。
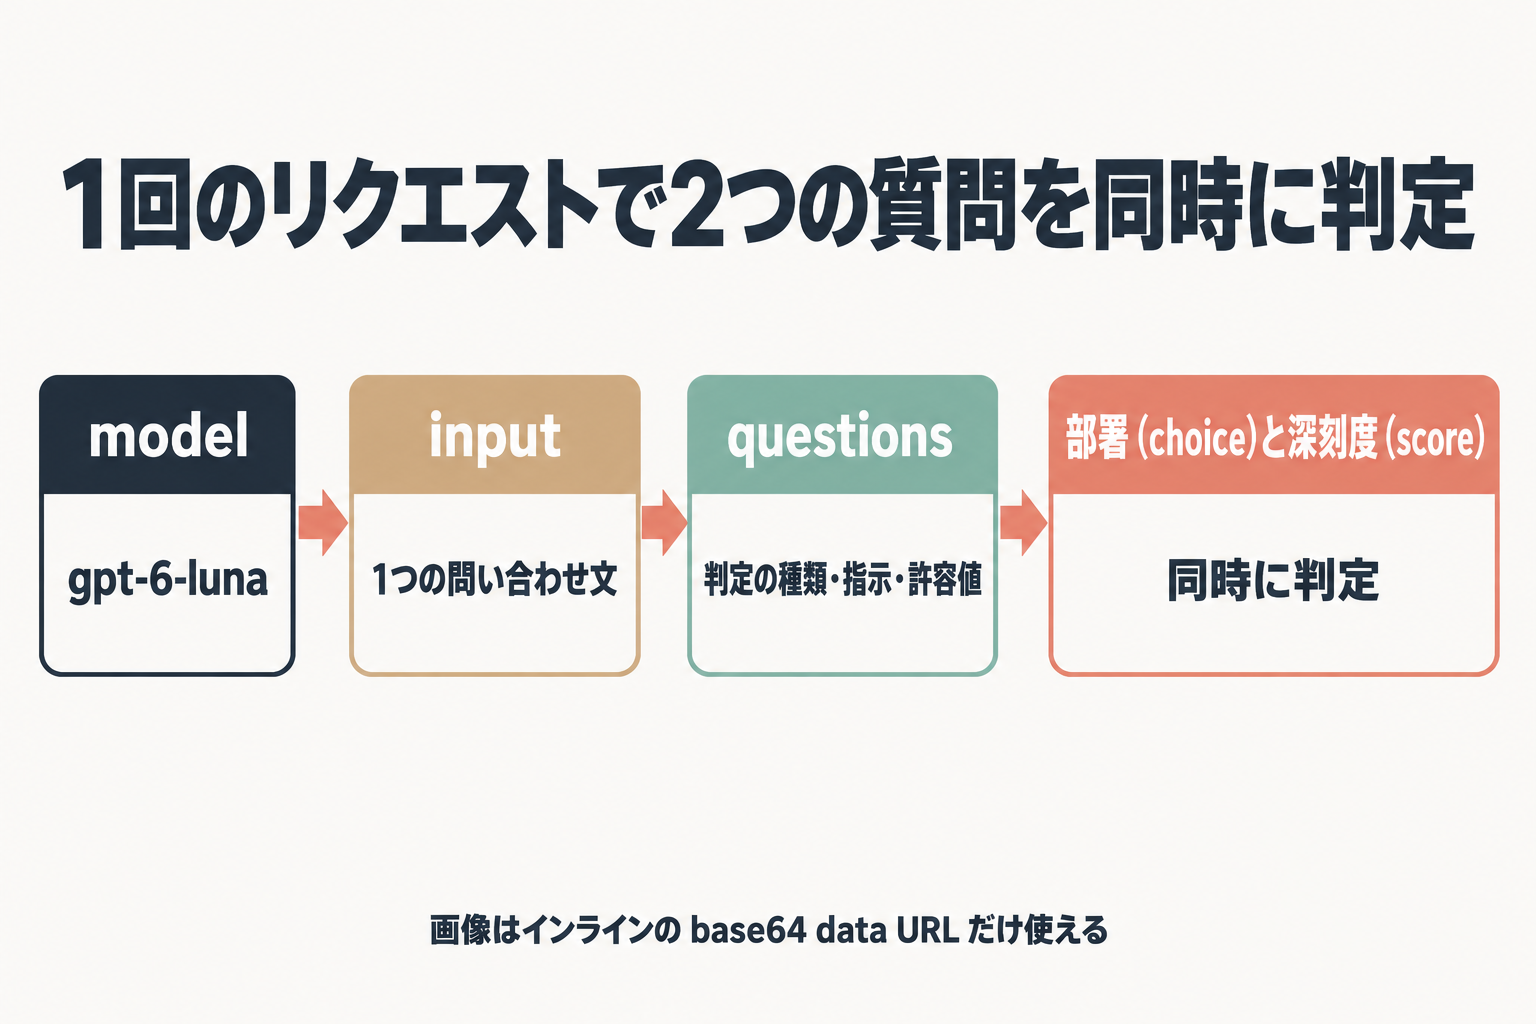
| 要素 | 中身 |
|---|---|
| model | gpt-6-luna |
| input | 文字列、またはテキストと画像を含む user メッセージ |
| questions | 判定の種類、指示、許容値(選択肢やレベル) |
SDK では client.decisions.create(...) で呼びます。公式の Python 例は、input に「I was charged twice for my order.」(注文で二重に請求された)を入れ、choice の department で振り分けるものです。選択肢は billing(支払い・請求書・返金)と other(上記以外の依頼)の2つです。
ここで大事なのは other です。どれにも当てはまらない入力が来たとき、無理に既存の選択肢へ押し込まないための逃げ道です。公式例にこの形が載っているので、自分で選択肢を作るときも最後に1つ置いておくと安全です。
画像の渡し方には制約があります。インラインの base64 data URL だけが使え、HTTP/HTTPS の URL と file_id は使えません。input_text と input_image は同じ user メッセージに混ぜられます。
互いに独立した質問は、1回のリクエストの questions 配列にまとめられます。たとえば「部署」と「深刻度」を同時に聞けます。前の判定結果で次の質問が変わる場合は、リクエストを分けます。
他の API との使い分け
公式の説明を表にすると、次のとおりです。
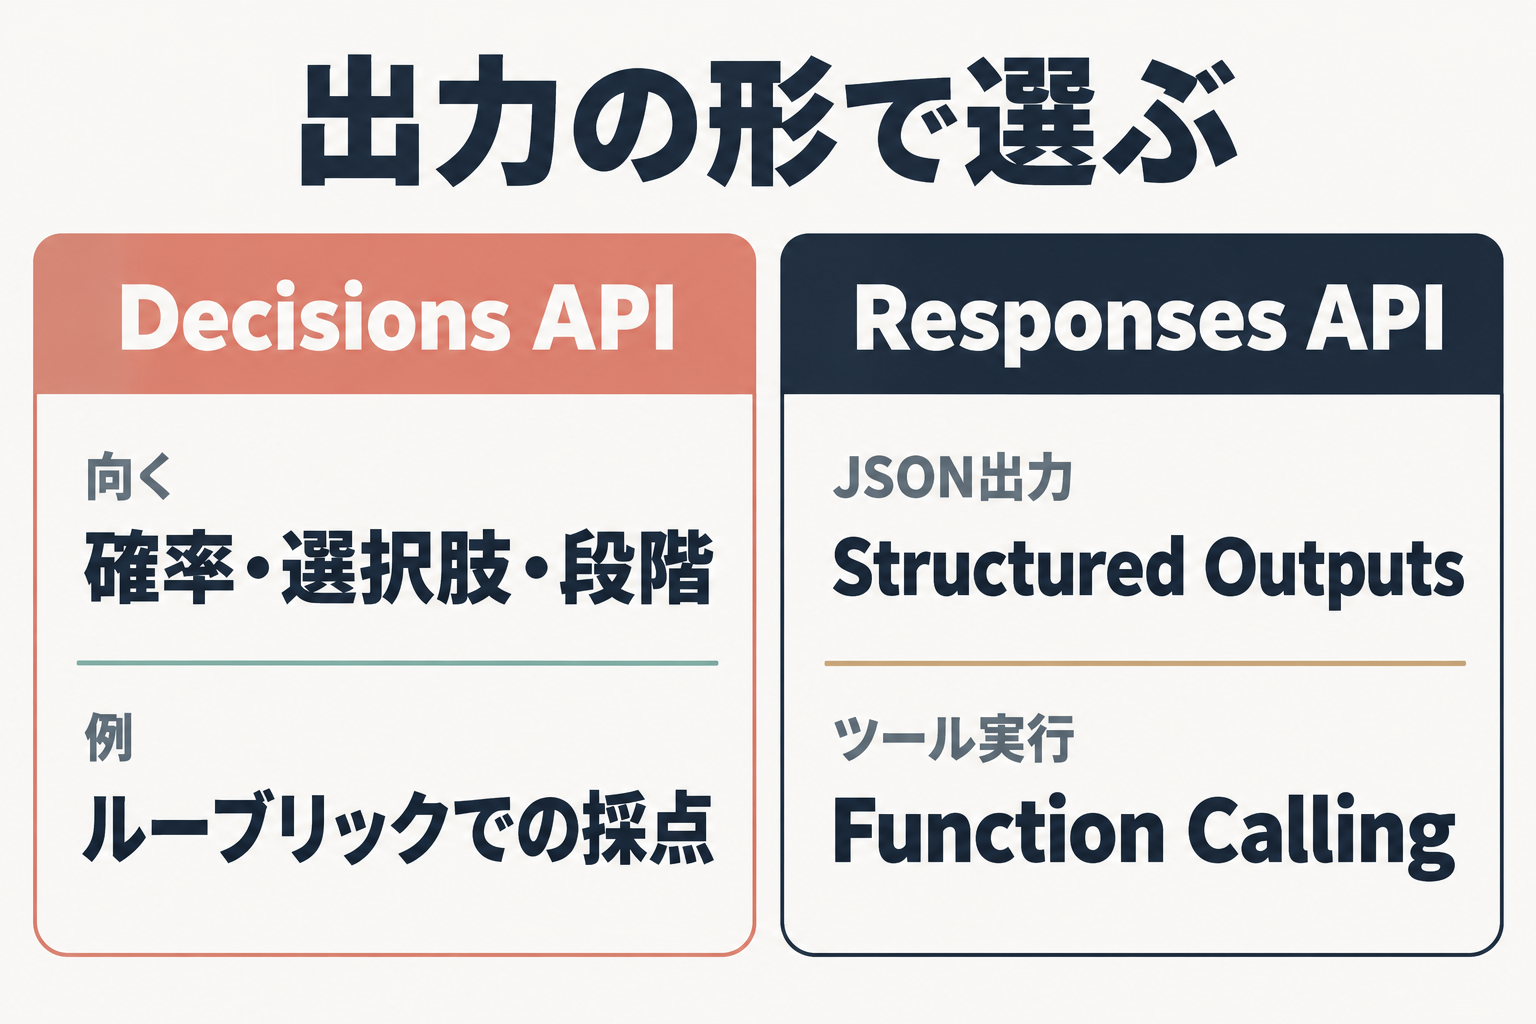
| やりたいこと | 向く API |
|---|---|
| 二値の確率、固定の選択、ルーブリック(採点基準)での採点 | Decisions API |
| 任意の JSON スキーマで出力させたい | Responses API + Structured Outputs(出力を指定したJSONの型に揃える機能) |
| ツール(関数)を実行させたい | Responses API + Function Calling(モデルが外部の関数を呼ぶ仕組み) |
見分け方はシンプルです。出力が「確率・選択肢・段階」のどれかに収まるなら Decisions、自由な形のデータを作らせたり外部の処理を呼ばせたりするなら Responses です。
速度の「最大10倍」は、比較の基準が決まっています。コミュニティ告知では、GPT-6 Luna を Responses API 経由で使う場合との比較です。ほかのモデルや自前のルール処理と比べた数字ではありません。応答時間そのものの数値(何ミリ秒か)は、公式のガイドや告知には載っていません。「約150ms」のような絶対値を見かけても、公式の記載ではない点に注意してください。
問い合わせの振り分けなど判定だけ要る人には、入力$0.10/100万トークンで出力課金なし
OpenAI Decisions API の料金プランを確認する(公式)料金と提供範囲
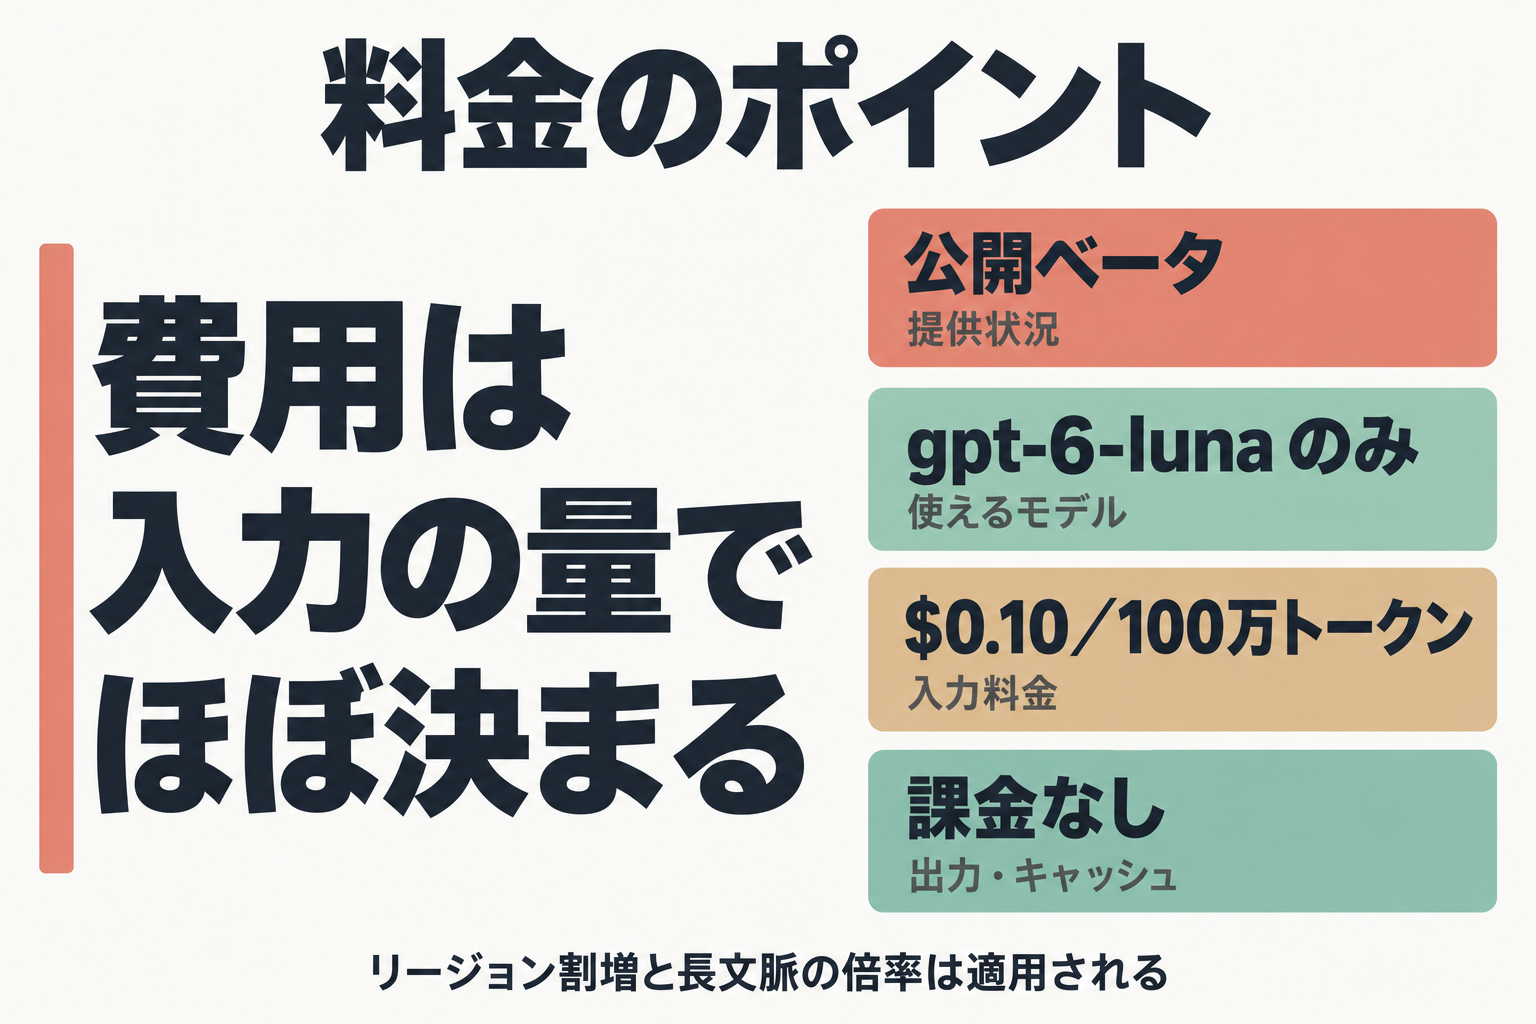
| 項目 | 内容 |
|---|---|
| 提供状況 | 公開ベータ(全開発者向け)。ガイドには「GAは近日」と記載 |
| 使えるモデル | gpt-6-luna のみ |
| 入力料金 | $0.10/100万トークン |
| 出力トークン・キャッシュの読み書き | 課金なし |
| 適用される割増 | リージョン処理の割増と長文脈の倍率は適用される |
| データ面 | ZDR(ゼロデータ保持)と HIPAA に対応(対象顧客)。データレジデンシーは米国と欧州(EEA・スイス) |
出力が課金されないので、費用は入力の量でほぼ決まります。単純な計算例です。1回の判定で入力が500トークンなら、100万トークンで2,000回、費用は $0.10 です。1万回なら $0.50 になります。これは単価からの換算で、実際の請求額ではありません。リージョン割増や長文脈の倍率が付くと変わります。
注意点が2つあります。まず、公式の料金ページには Decisions API の項目がまだなく、料金の根拠はガイドとコミュニティ告知です。次に、レート制限は Decisions 専用の記載が見当たりません。gpt-6-luna のモデルページには Build tier で 5,000 RPM/2M TPM、Launch tier で 10,000 RPM/10M TPM とありますが、これが Decisions にそのまま当てはまるかは、使う前にアカウントの画面で確かめてください。
ほかの OpenAI 製品の料金体系を参考にしながら見積もりたい場合は、GPT-6.1 Solとは|Astra比1/5価格で乗り換え判断で複数モデルの単価を比較できます。
使いどころと設計の注意
公式の例にあるのは、苦情の部署振り分け、傷の有無、深刻度の採点です。次の3つは公式の例ではなく、同じ型に当てはめた「想定される使い方」です。
- 問い合わせ窓口:内容を choice で分類し、担当部署のキューに振り分ける。
- モデルの切り替え:質問の難しさを score で測り、簡単なら軽いモデル、難しければ大きなモデルに回す。
- 画像つきの報告:写真に写っている不具合の有無を predicate で判定する。
実装例として、AIエージェント業務自動化事例|営業60%増の内訳のようなケーススタディを参考にすると、判定の実務的な使い道が見える。
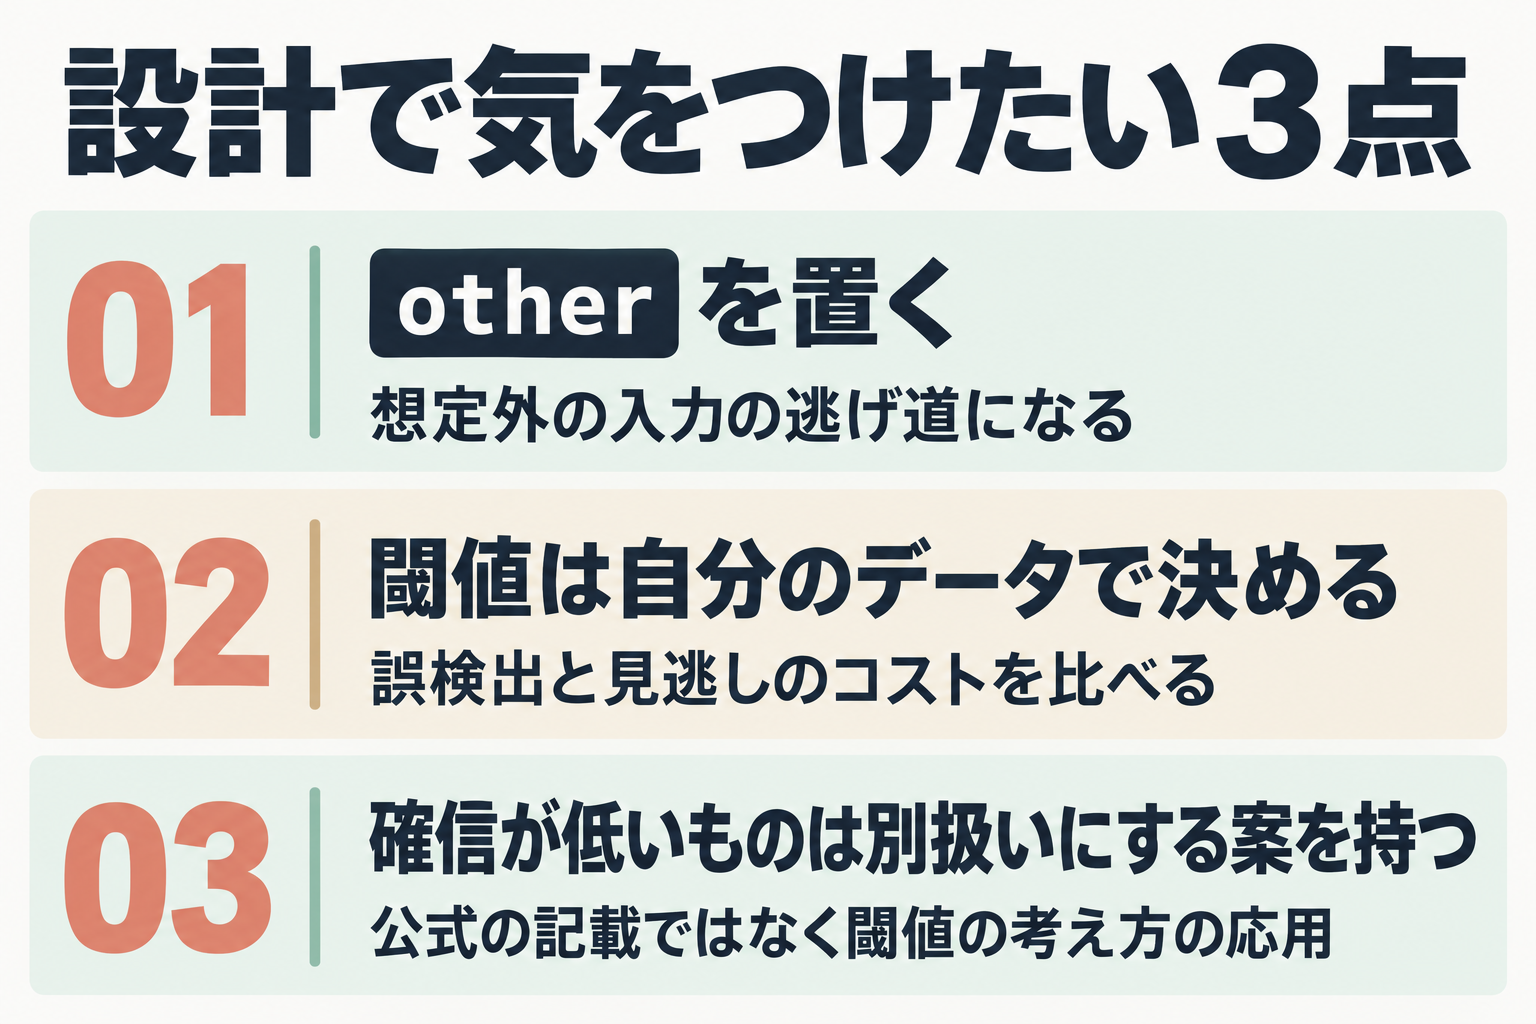
設計で気をつけたいのは次の3点です。
otherを置く。 想定外の入力の逃げ道になります。- 閾値(しきいち:どの数値から先を自動処理にするかの境目)は自分のデータで決める。 公式は、アプリ側のラベル付き例を使い、誤検出と見逃しのコストを比べて、ルーティングやフィルタの閾値を決めるよう案内しています。
- 確信が低いものは別扱いにする案を持つ。 たとえば confidence が低いときに人の確認へ回す運用は、公式の記載ではなく、上の閾値の考え方の応用です。
向いている人・向かない人
| 向く | 向かない |
|---|---|
| 振り分けが遅い、または複雑で保守に困っている | モデルを1つしか使わない |
| 複数のモデルやツールを使い分けている | ベータの仕様変更を許容できない本番用途 |
| 分類やスコアリングを大量にさばきたい | 自由な文章やJSONを作らせたい(Responses API 向き) |
| 画像を base64 で渡せる | 画像を URL や file_id で渡したい |
初期の利用者からは、choice の確率の較正(数値が実際の当たりやすさと合っているか)が難しい、predicate のほうが安定している、という声が出ています。公式の見解ではなく、コミュニティ告知のスレッドでのユーザー報告です。ベータなので、本番に入れる前に自分のデータで確率の信頼度を見ておくのが安全です。
今日試す最初の一歩
以下は公式の案内に沿った進め方で、私たちが手を動かして確かめた手順ではありません。
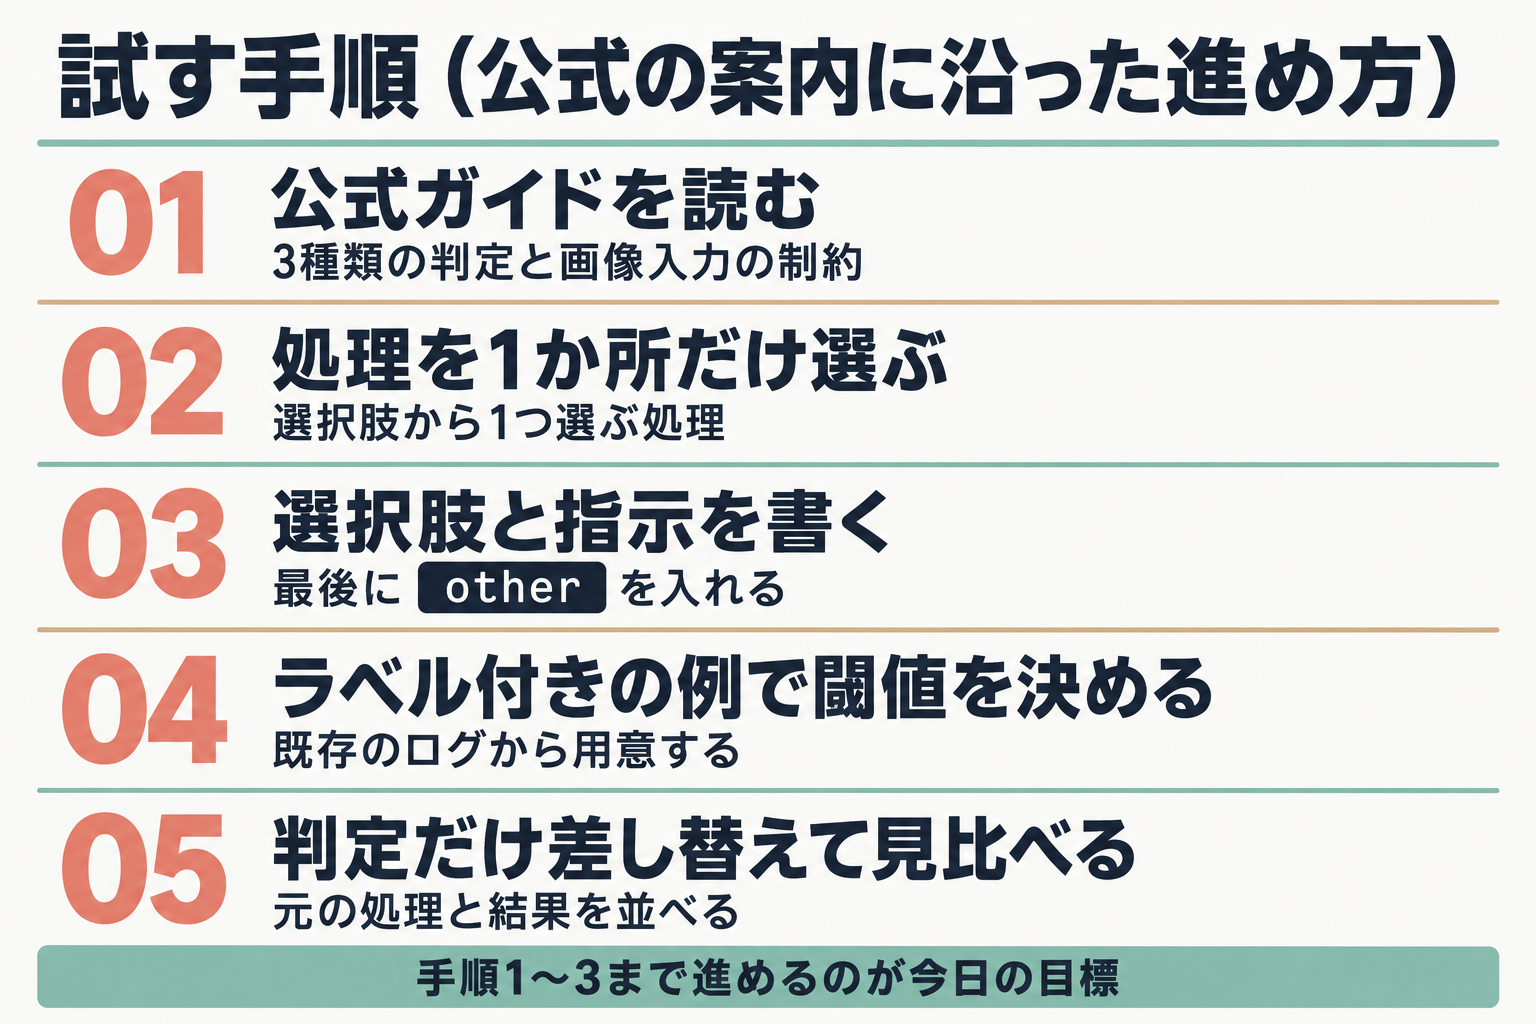
- 公式ガイドで3種類の判定の定義と、画像入力の制約を読む。
- アプリの中から、「選択肢から1つ選ぶ」処理を1か所だけ選ぶ。
- 選択肢と指示を書き、最後に
otherを入れる。 - 既存のログからラベル付きの例を用意し、結果と照らして閾値を決める。
- 振り分けの判定だけ差し替えて、元の処理と結果を並べて見比べる。
今日やることは1つだけです。判断が1か所のアプリで、手順1〜3まで進めること。 公式の例(苦情の部署振り分け)は、そのまま自分の入力に置き換えやすい形です。
もっと詳しく
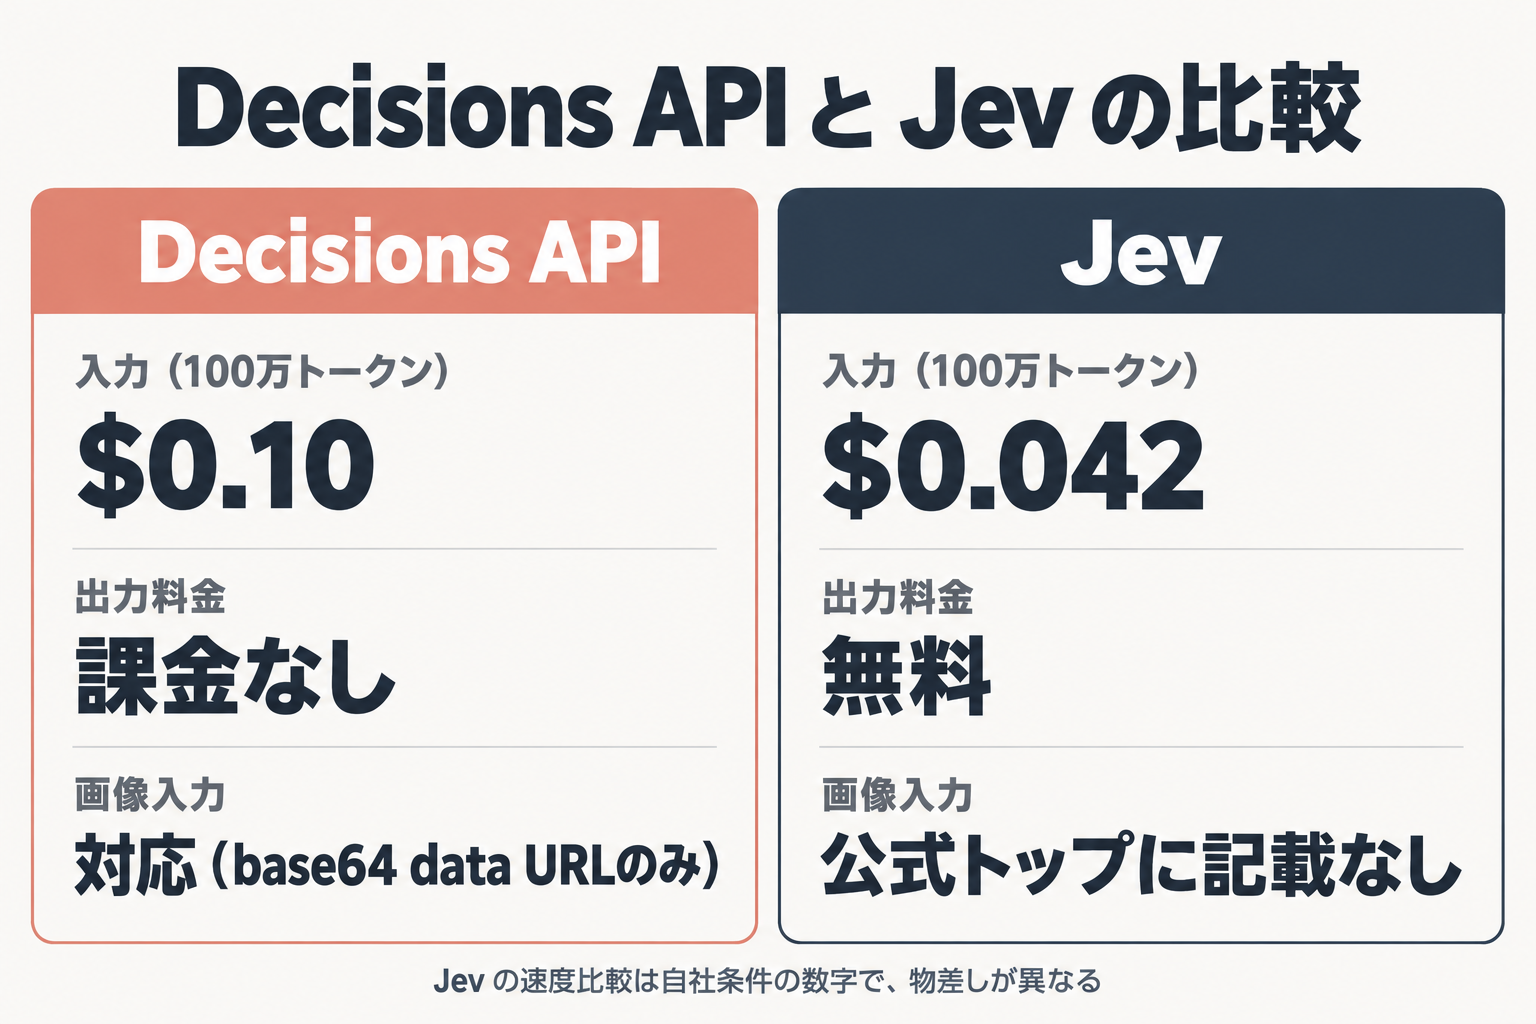
TypeSafe Jev との比較
同じ「確率つきの型付き判定」を返すサービスに、TypeSafe の Jev があります。公式トップの記載と二次情報から分かる範囲で並べます。
| 項目 | Decisions API | Jev |
|---|---|---|
| 入力料金(100万トークン) | $0.10 | $0.042 |
| 出力料金 | 課金なし | 無料(二次情報でも一致) |
| 画像入力 | 対応(base64 data URL のみ) | 公式トップに記載なし |
| 最大選択肢数 | 公式に記載なし | 公式トップに記載なし |
| 速度の公称 | Responses API 比で最大10倍 | 自社条件で約0.114秒 vs 8.566秒と比較 |
入力料金だけで見れば Jev のほうが安く、画像を扱うなら Decisions API の仕様のほうが明確です。Jev の速度比較は自社の条件で出した数字で、Decisions API の「最大10倍」と同じ物差しではありません。選ぶ軸は「画像が要るか」「料金」「確率の見え方」です。Jev の入力形式や選択肢の上限は、申し込み前に公式で確かめてください。
gpt-6-luna のモデル仕様
モデルページには、コンテキスト 1,050,000 トークン、最大入力 922,000、最大出力 128,000、知識カットオフ 2026-05-18、入力はテキストと画像、と記載があります。ただし対応 API として載っているのは Chat Completions、Responses、Batch で、Decisions は並んでいません。ページ上の出力単価 $0.5/100万は通常の API の価格で、Decisions の「出力課金なし」とは別です。
ほかの発表を知りたい人へ
同じ時期の OpenAI の開発者向けの発表は、OpenAI DevDay 2026まとめ|今日使える変更点にまとめています。
仕様が変わる前提で
Decisions API はベータで、GA は近日とされています。条件や仕様は変わりうるので、組み込む前に公式ガイドと料金の最新の記載を確認してください。